
Tháng 5/2026, cộng đồng AI ghi nhận sự ra mắt của PaddleOCR-VL-1.6, một mô hình document parsing tiên tiến đạt tỷ lệ chính xác 96,33% trên tập benchmark OmniDocBench v1.6, một tiêu chuẩn đánh giá toàn diện khả năng hiểu và trích xuất nội dung tài liệu đa dạng. Với kết quả này, giới kỹ thuật và lãnh đạo doanh nghiệp bắt đầu cân nhắc: liệu có thể tự xây hệ thống document AI dựa trên mô hình mở nguồn thay vì phụ thuộc hoàn toàn vào các dịch vụ thương mại như Google Document AI hay Microsoft Form Recognizer?
1. PaddleOCR-VL-1.6 là gì và kết quả trên OmniDocBench v1.6
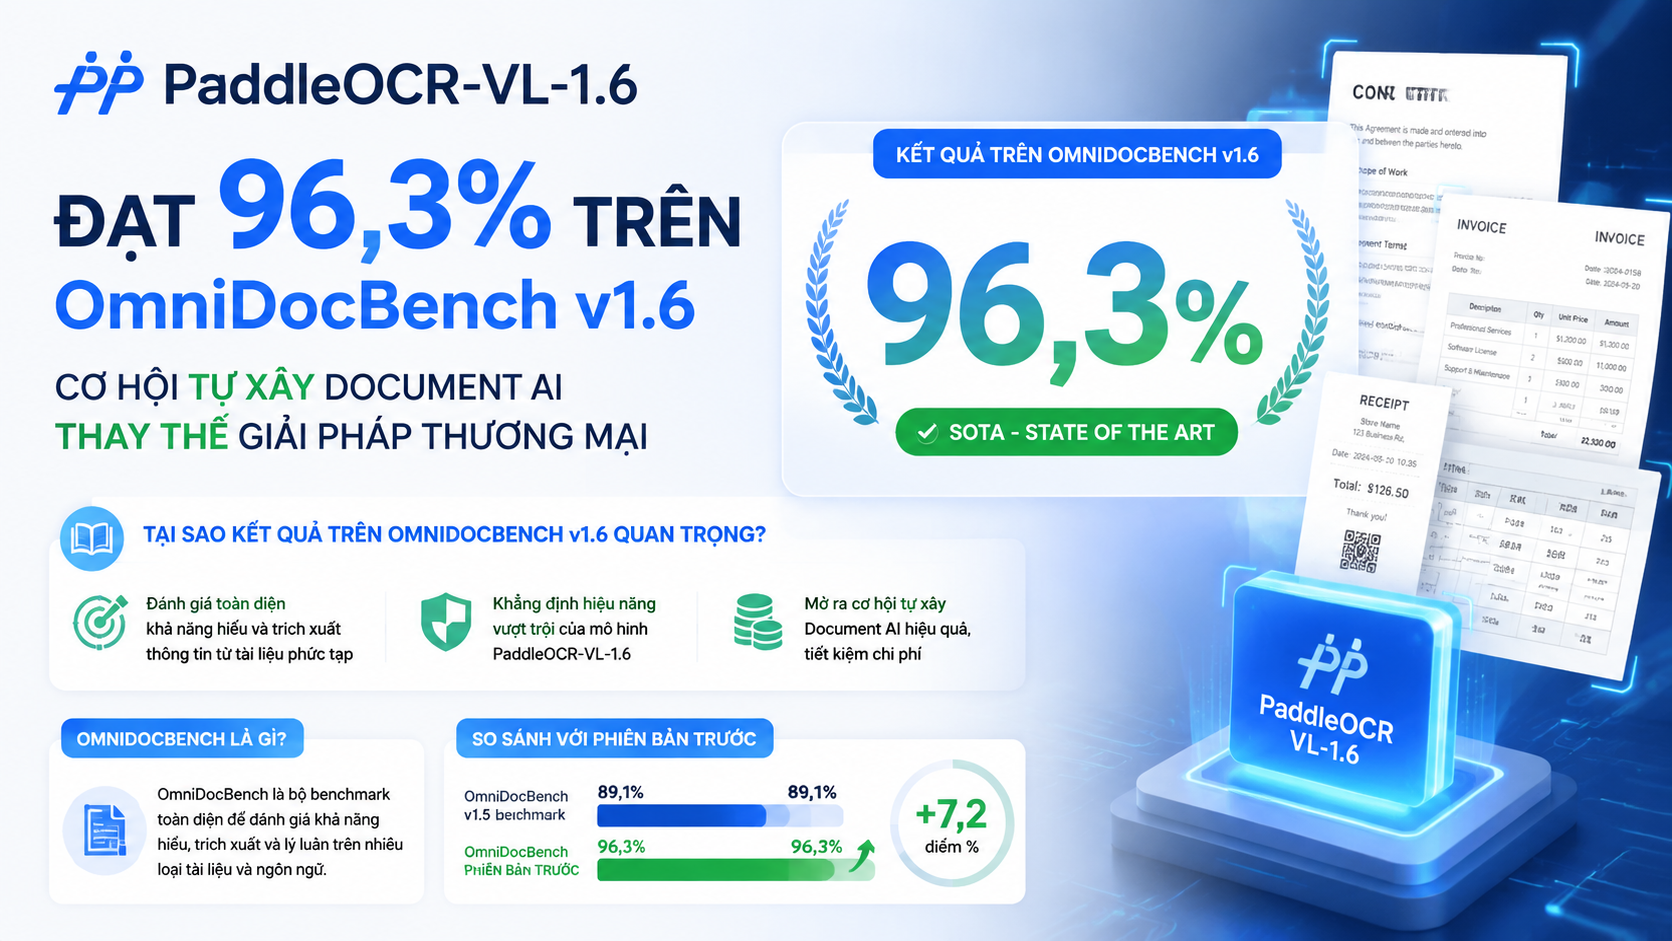
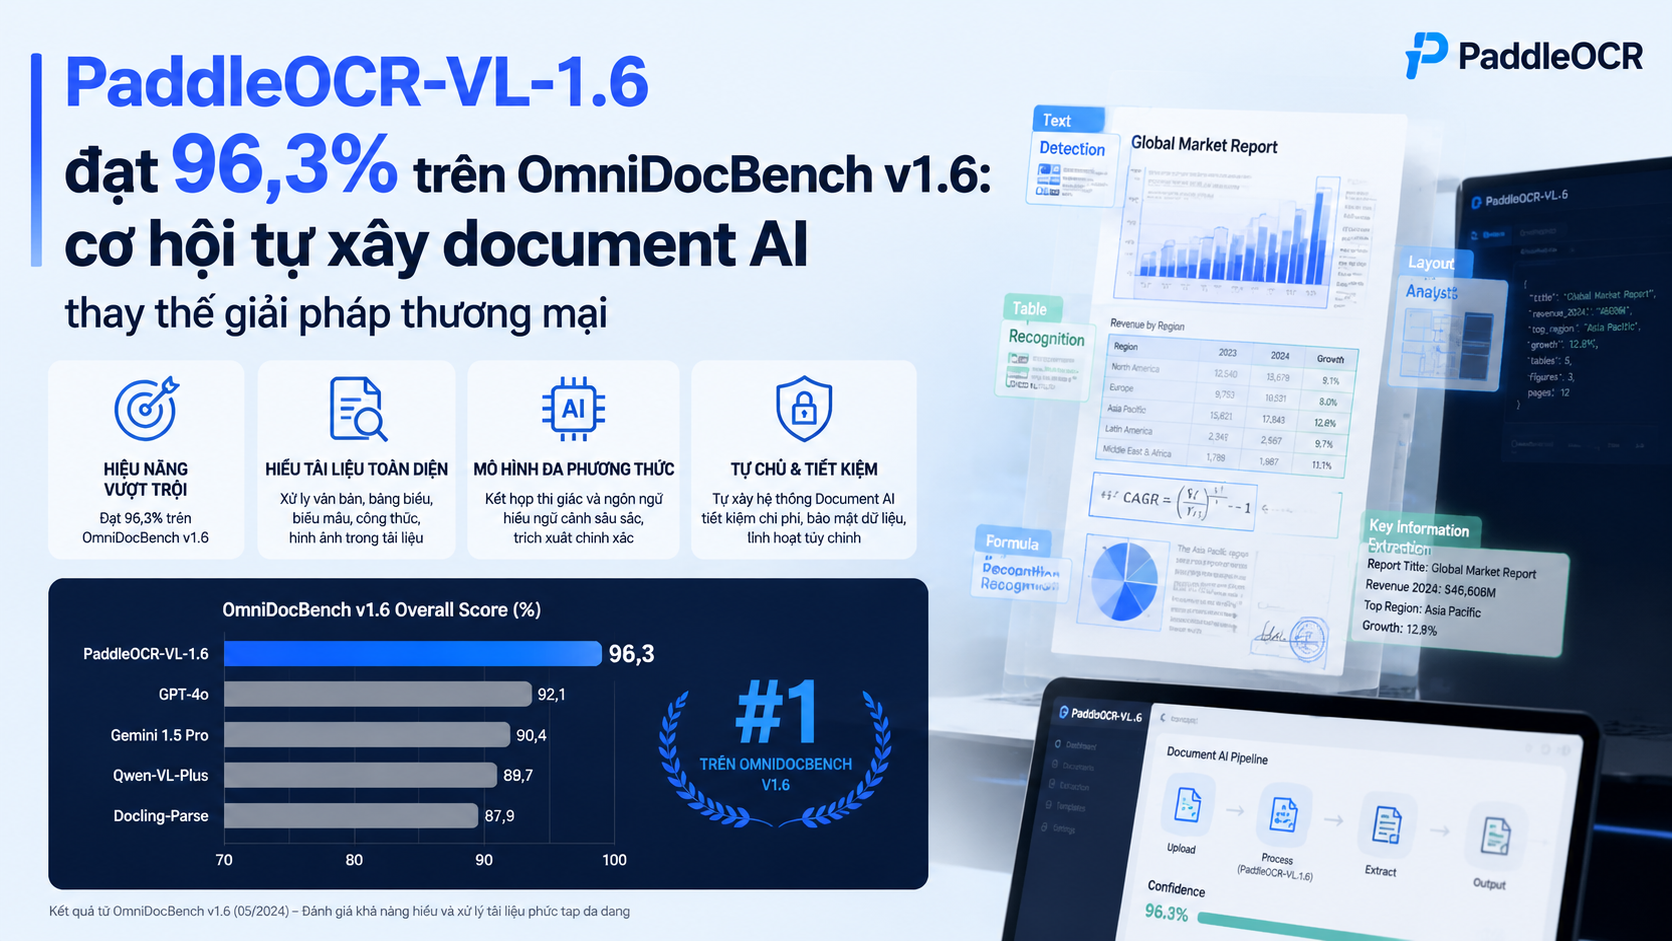
Minh họa kết quả benchmark OmniDocBench v1.6 của PaddleOCR-VL-1.6 đạt 96,33%.
1.1. Giới thiệu tổng quan mô hình
PaddleOCR-VL-1.6 thuộc dòng mô hình document parsing, tích hợp sâu khả năng nhận diện ký tự, bảng biểu, công thức và bố cục tài liệu. Phiên bản mới nhất được phát triển dựa trên kiến trúc vision-language model (VLM) với mức tham số khoảng 0,9 tỷ, tối ưu dữ liệu vùng yếu và huấn luyện hậu tiến độ để cải thiện độ chính xác tổng thể và tính ổn định khi xử lý các thành phần phức tạp trong tài liệu. Điều này khiến mô hình không chỉ dừng lại ở việc nhận dạng chữ viết, mà còn hiểu cấu trúc logic của các thành phần như bảng, biểu đồ, và công thức. Nguồn tham khảo: Centrix.
1.2. Benchmark OmniDocBench v1.6
Trên OmniDocBench v1.6 – một bộ benchmark được thiết kế để đánh giá khả năng trích xuất thông tin từ tài liệu đa dạng – PaddleOCR-VL-1.6 đạt điểm tổng thể 96,33%, vượt qua nhiều mô hình OCR mở nguồn và cả một số giải pháp thương mại lớn. Kết quả này phản ánh năng lực xử lý văn bản, bảng và công thức trong tài liệu ở mức rất cao, đồng thời khẳng định khả năng cạnh tranh của mô hình mở nguồn với các hệ thống đóng và trả phí hiện nay trong tác vụ parsing toàn diện, bao gồm cả nhận diện bố cục phức tạp và phân tích ngữ cảnh.
2. Tại sao kết quả trên OmniDocBench v1.6 quan trọng?
2.1. OmniDocBench là gì?
OmniDocBench là benchmark chuẩn rộng rãi trong cộng đồng OCR và document AI để đo năng lực mô hình trong nhiều khía cạnh khác nhau: nhận diện văn bản, bảng biểu, công thức, thứ tự đọc và cấu trúc tài liệu tổng thể. Thành tích 96,33% trên benchmark này cho thấy PaddleOCR-VL-1.6 không chỉ tốt ở một phần nhỏ của nhiệm vụ OCR mà còn đồng đều trong những hạng mục khó như bảng biểu và ký tự hiếm, điều mà nhiều mô hình chỉ tập trung vào nhận dạng ký tự đơn thuần thường chưa làm tốt.
2.2. So sánh với phiên bản trước
So với phiên bản trước đó là PaddleOCR-VL-1.5, PaddleOCR-VL-1.6 được huấn luyện thêm bằng cách tối ưu hóa dữ liệu vùng yếu và áp dụng chiến lược hậu huấn luyện tiến độ, từ đó cải thiện đáng kể hiệu suất nhận diện bảng, công thức và các yếu tố bố cục phức tạp. Cải tiến này giúp mô hình hoạt động mạnh mẽ hơn trên tài liệu thực tế, đặc biệt là các tài liệu độ phân giải thấp, bố cục phức tạp hoặc chứa nhiều ký tự đặc biệt. Nguồn tham khảo: CentriX.digital
3. Cơ hội tự xây document AI so với giải pháp thương mại
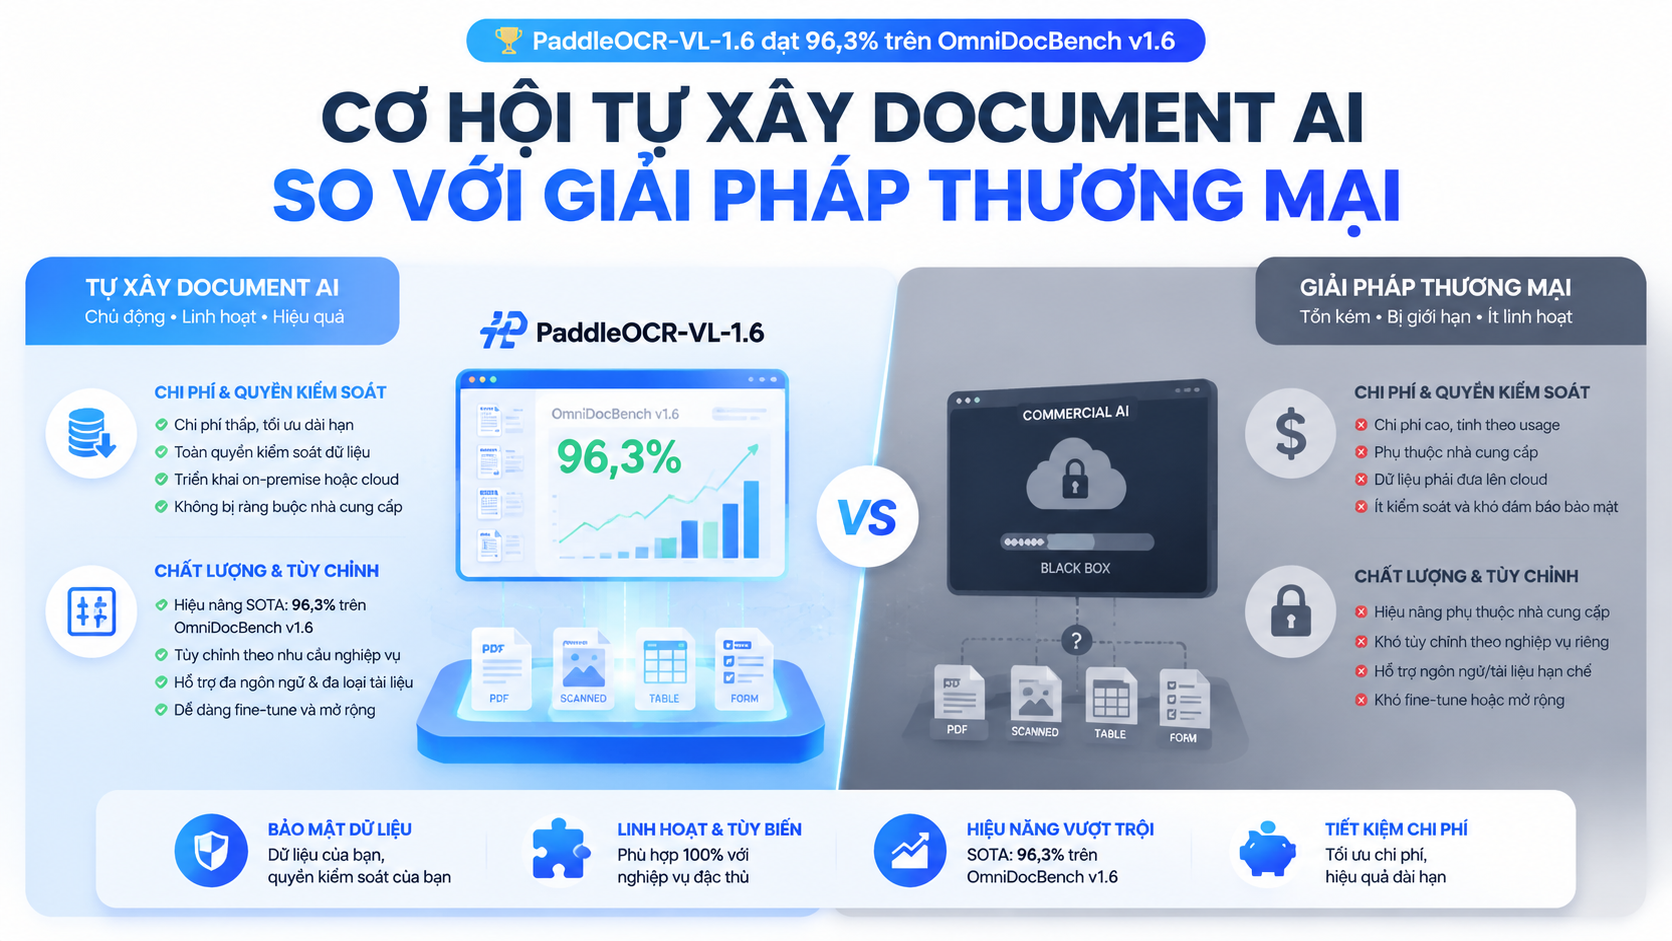
Sơ đồ tổng quan pipeline OCR và document parsing cho giải pháp tự xây.
3.1. Chi phí và quyền kiểm soát
Tự xây document AI dựa trên model như PaddleOCR-VL-1.6 cho phép doanh nghiệp kiểm soát dữ liệu đầu vào, xử lý và lưu trữ hoàn toàn nội bộ, điều này đặc biệt quan trọng khi xử lý tài liệu chứa thông tin nhạy cảm. So với dịch vụ thương mại thường tính phí theo lượt xử lý và gắn với chi phí dài hạn cao, giải pháp tự host có thể tối ưu chi phí cho khối lượng lớn tài liệu mà vẫn đảm bảo kiểm soát quyền riêng tư và tuân thủ quy định bảo mật dữ liệu nội bộ.
3.2. Chất lượng và tùy chỉnh
Với khả năng xuất đầu ra có cấu trúc như Markdown và JSON, PaddleOCR-VL-1.6 giúp doanh nghiệp linh hoạt tích hợp với hệ thống backend, pipeline dữ liệu và các ứng dụng downstream như tìm kiếm tài liệu, tóm tắt bằng LLM hoặc phân tích dữ liệu chuyên sâu. Hơn nữa, vì là mô hình mở nguồn, doanh nghiệp có thể tinh chỉnh và huấn luyện thêm trên dữ liệu nội bộ để tối ưu hoá theo nghiệp vụ đặc thù, điều mà các dịch vụ thương mại kín không dễ thực hiện.
4. Khi nào nên tự xây document AI và khi nào nên dùng dịch vụ
4.1. Trường hợp phù hợp tự host
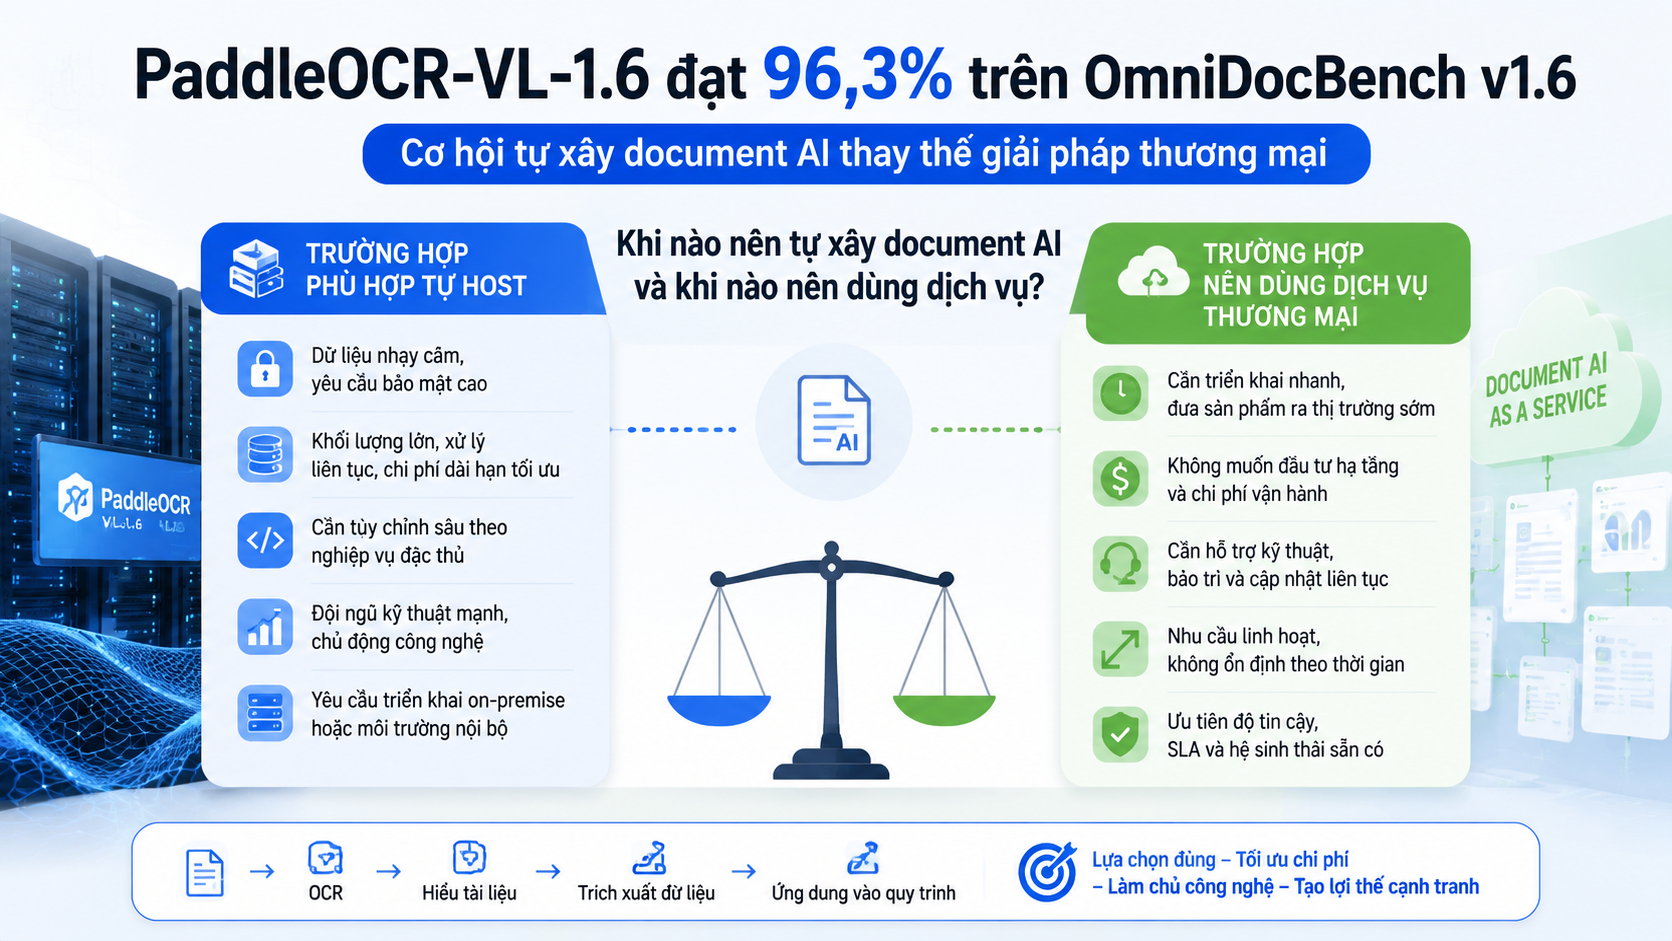
Đối với doanh nghiệp xử lý khối lượng tài liệu lớn hàng tháng, có yêu cầu bảo mật và kiểm soát dữ liệu nội bộ hoặc cần tùy chỉnh sâu theo workflow nội bộ, tự host document AI với PaddleOCR-VL-1.6 là lựa chọn phù hợp. Việc tự xây còn giúp giảm lệ phí dịch vụ theo lượt xử lý và tránh phụ thuộc vào bên thứ ba.
4.2. Trường hợp nên dùng dịch vụ thương mại
Ngược lại, với nhóm nhỏ, khối lượng tài liệu thấp hoặc doanh nghiệp không có đội ngũ kỹ thuật để triển khai và duy trì hệ thống nội bộ, dịch vụ thương mại vẫn phù hợp hơn vì triển khai nhanh và có hỗ trợ kỹ thuật từ nhà cung cấp.
5. Kỹ thuật và câu chuyện triển khai
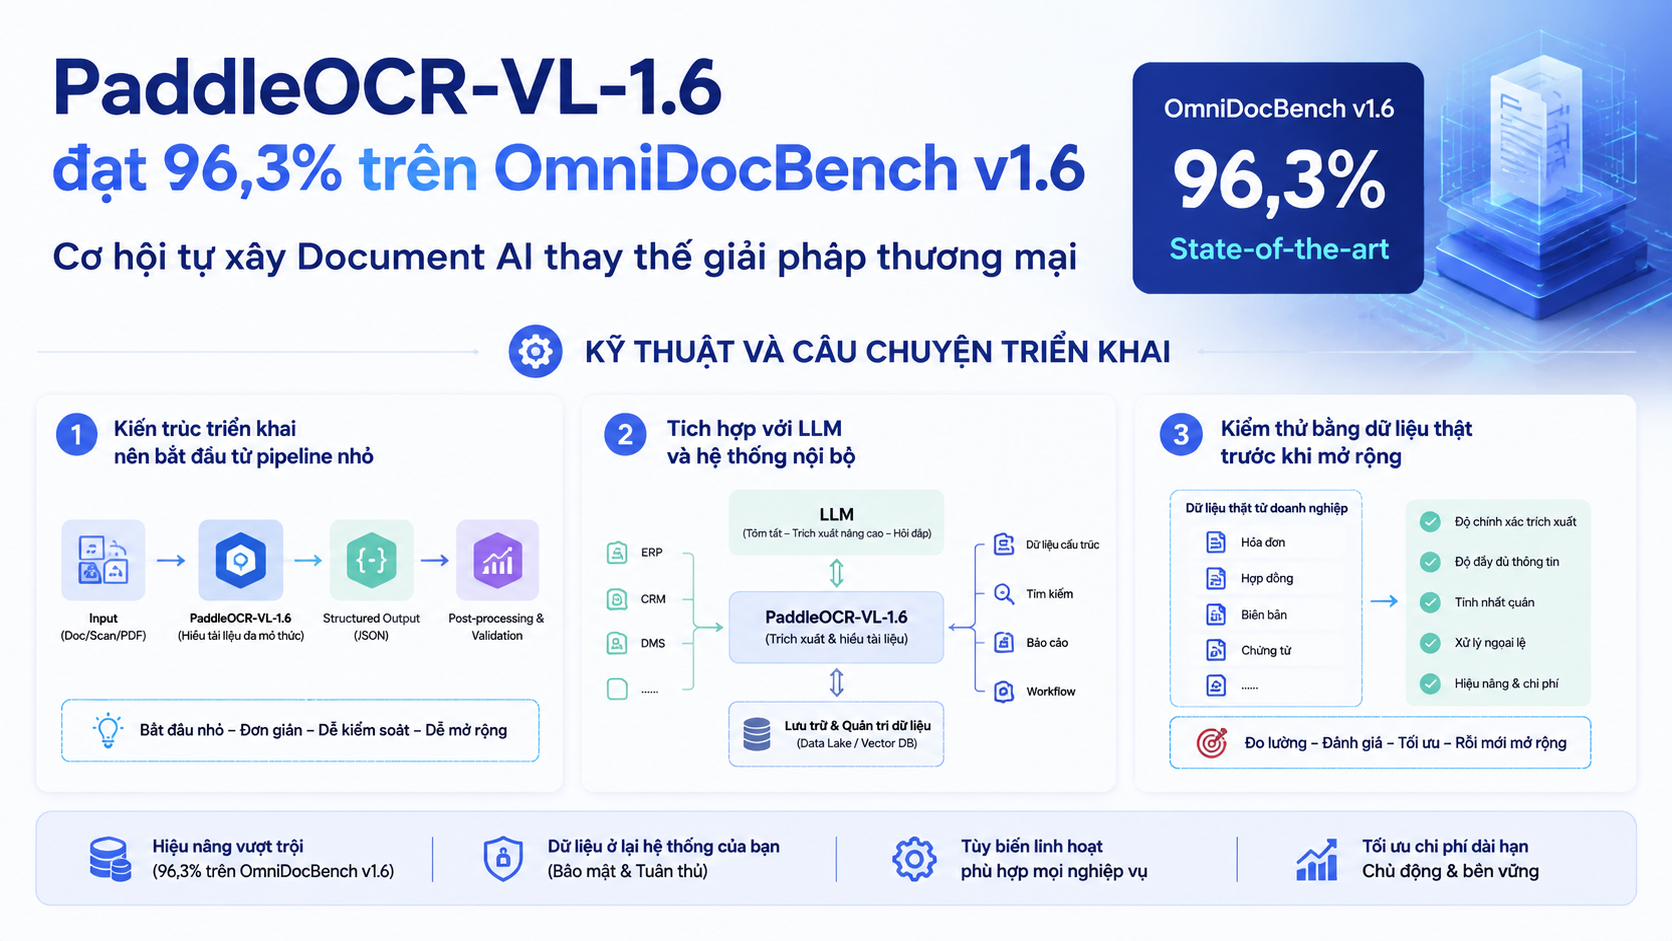
Để biến PaddleOCR-VL-1.6 thành một hệ thống document AI dùng được trong doanh nghiệp, đội kỹ thuật cần nhìn mô hình như một thành phần trong pipeline, không phải là toàn bộ sản phẩm. Theo trang mô hình PaddleOCR-VL-1.6 trên Hugging Face, mô hình được giới thiệu như bản nâng cấp phục vụ document parsing, còn tài liệu chính thức của PaddleOCR nhấn mạnh khả năng xử lý văn bản, bảng, công thức và thứ tự đọc. Điều này rất phù hợp với bài toán tài liệu doanh nghiệp, nơi dữ liệu thường nằm trong PDF scan, ảnh chụp, biểu mẫu, hợp đồng, hóa đơn hoặc báo cáo nhiều trang.
5.1. Kiến trúc triển khai nên bắt đầu từ pipeline nhỏ
Một kiến trúc thực tế nên gồm 5 lớp: tiếp nhận tài liệu, tiền xử lý ảnh/PDF, chạy OCR và layout parsing, chuẩn hóa dữ liệu đầu ra, sau đó đưa kết quả vào hệ thống tìm kiếm hoặc workflow duyệt. Với tài liệu quan trọng, nên lưu đồng thời file gốc, kết quả Markdown, kết quả JSON và log xử lý để truy vết khi cần kiểm toán.
Ví dụ, một doanh nghiệp logistics có thể dùng pipeline này để đọc vận đơn, bảng kê hàng hóa và chứng từ hải quan. Thay vì nhập tay từng trường, hệ thống tự trích xuất số vận đơn, ngày phát hành, bên gửi, bên nhận, số container và bảng chi phí. Nhân viên chỉ kiểm tra các trường có độ tin cậy thấp hoặc giá trị bất thường.
5.2. Tích hợp với LLM và hệ thống nội bộ
Điểm mạnh của PaddleOCR-VL-1.6 nằm ở việc tạo dữ liệu có cấu trúc để dùng tiếp ở các lớp AI khác. Sau OCR, doanh nghiệp có thể đưa Markdown vào LLM để tóm tắt tài liệu, so sánh phiên bản, phát hiện thiếu chữ ký hoặc tạo câu trả lời theo ngữ cảnh nội bộ. Với JSON, dữ liệu có thể đồng bộ vào CRM, ERP, DMS hoặc kho dữ liệu phân tích.
Tuy nhiên, không nên để LLM tự quyết định các thông tin có rủi ro cao. Với hợp đồng, hóa đơn, chứng từ tài chính hoặc hồ sơ nhân sự, cần có bước kiểm duyệt của người phụ trách nghiệp vụ. Đây là nguyên tắc E-E-A-T quan trọng: mô hình giúp tăng tốc xử lý, nhưng trách nhiệm xác nhận cuối cùng vẫn thuộc về chuyên gia có thẩm quyền.
5.3. Kiểm thử bằng dữ liệu thật trước khi mở rộng
Trước khi triển khai rộng, hãy xây bộ kiểm thử đại diện cho tài liệu thật của doanh nghiệp. Bộ test nên có tài liệu rõ nét, tài liệu scan nghiêng, tài liệu có bảng phức tạp, tài liệu đa ngôn ngữ và các mẫu có dấu, chữ ký hoặc watermark. Kết quả benchmark 96,33% trên OmniDocBench v1.6 là tín hiệu kỹ thuật mạnh, nhưng hiệu quả nội bộ vẫn phải được đo bằng KPI riêng như tỷ lệ nhận đúng trường quan trọng, thời gian xử lý mỗi trang, tỷ lệ cần con người sửa và chi phí vận hành.
6. So sánh ưu/nhược điểm giữa tự xây và giải pháp thương mại
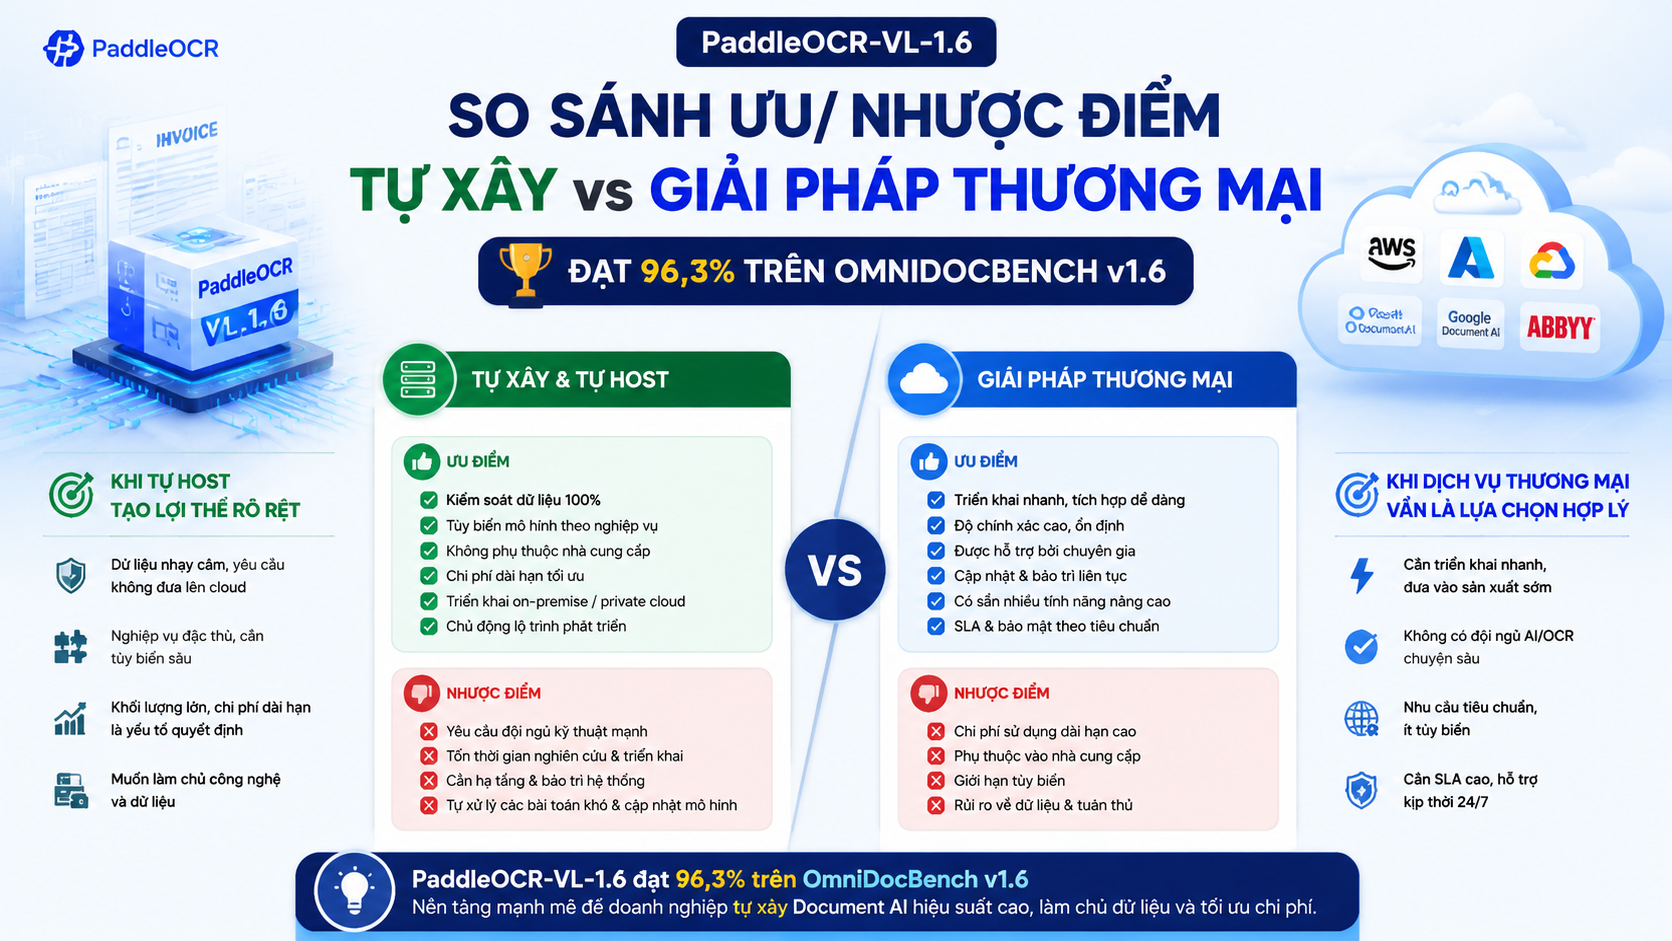
Quyết định tự xây document AI hay dùng dịch vụ thương mại không nên dựa vào một chỉ số benchmark duy nhất. Doanh nghiệp cần cân nhắc tổng chi phí sở hữu, độ nhạy cảm dữ liệu, năng lực đội kỹ thuật, tốc độ triển khai và mức độ tùy biến theo nghiệp vụ.
| Tiêu chí | Tự host PaddleOCR-VL-1.6 | Dịch vụ thương mại |
|---|---|---|
| Chi phí dài hạn | Có lợi khi xử lý khối lượng tài liệu lớn và có hạ tầng sẵn | Dễ bắt đầu nhưng chi phí có thể tăng theo số trang hoặc lượt gọi API |
| Quyền kiểm soát dữ liệu | Cao, có thể xử lý nội bộ và kiểm soát luồng dữ liệu | Phụ thuộc chính sách lưu trữ, vùng dữ liệu và điều khoản của nhà cung cấp |
| Tùy biến theo nghiệp vụ | Cao, có thể thiết kế schema, rule validation và workflow riêng | Thường nhanh nhưng bị giới hạn bởi template và API có sẵn |
| Tốc độ triển khai | Cần đội kỹ thuật, thử nghiệm và vận hành hạ tầng | Nhanh hơn cho nhu cầu tiêu chuẩn, ít tùy biến |
| Khả năng mở rộng | Linh hoạt nếu kiểm soát tốt GPU, hàng đợi xử lý và lưu trữ | Mở rộng dễ, nhưng phụ thuộc giá và giới hạn dịch vụ |
6.1. Khi tự host tạo lợi thế rõ rệt
Tự host phù hợp với tổ chức có dữ liệu nhạy cảm hoặc khối lượng tài liệu lớn: ngân hàng, bảo hiểm, logistics, pháp lý, y tế, giáo dục, sản xuất và thương mại điện tử. Trong các ngành này, tài liệu không chỉ cần được đọc đúng mà còn phải được truy vết, phân quyền và tích hợp sâu vào hệ thống nghiệp vụ. Nếu đã có đội dữ liệu hoặc đội DevOps, PaddleOCR-VL-1.6 có thể trở thành nền tảng mở để xây pipeline riêng.
6.2. Khi dịch vụ thương mại vẫn là lựa chọn hợp lý
Với doanh nghiệp nhỏ, đội ngũ chưa có năng lực vận hành AI hoặc chỉ xử lý vài trăm tài liệu mỗi tháng, dịch vụ thương mại vẫn có giá trị nhờ khả năng triển khai nhanh, tài liệu hướng dẫn sẵn và hỗ trợ kỹ thuật. Cách tiếp cận thực tế là bắt đầu bằng dịch vụ có sẵn để hiểu quy trình, sau đó chuyển một phần workload sang tự host khi khối lượng, chi phí hoặc yêu cầu kiểm soát dữ liệu tăng lên.
7. FAQ: Câu hỏi thường gặp về PaddleOCR-VL-1.6 và document AI tự host
PaddleOCR-VL-1.6 có phải là giải pháp thay thế hoàn toàn cho Google Document AI hoặc Microsoft Form Recognizer không?
Không phải trong mọi trường hợp. PaddleOCR-VL-1.6 là lựa chọn mạnh cho doanh nghiệp muốn tự kiểm soát dữ liệu và tùy chỉnh pipeline. Tuy nhiên, dịch vụ thương mại vẫn có lợi thế về triển khai nhanh, SLA, giao diện quản trị và hỗ trợ kỹ thuật.
Benchmark 96,33% trên OmniDocBench v1.6 có đủ để đưa vào production không?
Chưa đủ. Benchmark là cơ sở đánh giá năng lực mô hình, nhưng production cần kiểm thử trên dữ liệu thật. Doanh nghiệp nên đo thêm độ chính xác theo trường dữ liệu, tốc độ xử lý, tỷ lệ lỗi nghiêm trọng và mức độ can thiệp của con người.
Cần đội ngũ nào để tự xây document AI?
Tối thiểu nên có kỹ sư backend hoặc data engineer để xây pipeline, người phụ trách hạ tầng để vận hành, và chuyên gia nghiệp vụ để định nghĩa trường dữ liệu, rule kiểm tra và tiêu chuẩn duyệt. Với hệ thống lớn, nên có thêm ML engineer để tối ưu hiệu năng và giám sát chất lượng mô hình.
Có thể kết hợp PaddleOCR-VL-1.6 với ChatGPT, Claude hoặc Gemini không?
Có. OCR nên đảm nhiệm lớp trích xuất văn bản và cấu trúc, còn LLM nên đảm nhiệm lớp tóm tắt, hỏi đáp, phân loại và giải thích. Đây cũng là hướng CentriX.digital thường khuyến nghị: kết hợp tài khoản AI, phần mềm bản quyền và hạ tầng số để biến ý tưởng thành workflow hoàn chỉnh.
Rủi ro lớn nhất khi tự xây là gì?
Rủi ro lớn nhất thường không nằm ở mô hình mà ở vận hành: dữ liệu đầu vào kém, thiếu bước human review, không có log truy vết, không mã hóa dữ liệu hoặc không kiểm soát quyền truy cập. Vì vậy, dự án document AI cần được thiết kế như một hệ thống quản trị dữ liệu, không chỉ là một công cụ OCR.
8. Kết luận: bước tiếp theo để tự xây document AI
PaddleOCR-VL-1.6 đạt 96,33% trên OmniDocBench v1.6 là một tín hiệu quan trọng cho doanh nghiệp đang tìm kiếm giải pháp document AI tự chủ. Mô hình mở ra cơ hội giảm phụ thuộc vào dịch vụ thương mại, kiểm soát dữ liệu tốt hơn và tùy biến sâu theo nghiệp vụ nội bộ. Tuy vậy, quyết định tự xây cần đi kèm đánh giá thực tế về khối lượng tài liệu, năng lực kỹ thuật, yêu cầu bảo mật và tổng chi phí vận hành.
Bước đi khôn ngoan là bắt đầu bằng một pilot nhỏ: chọn 200-500 tài liệu đại diện, thiết kế schema đầu ra, đo chất lượng OCR, thử tích hợp với LLM và xác định tỷ lệ cần kiểm duyệt thủ công. Sau đó, doanh nghiệp mới nên quyết định mở rộng sang quy mô production.
CentriX.digital có thể đồng hành ở lớp công cụ AI, phần mềm bản quyền và hạ tầng số, giúp đội ngũ kỹ thuật và vận hành rút ngắn khoảng cách giữa ý tưởng document AI và một hệ thống có thể dùng thật trong công việc hằng ngày.