
Trong làn sóng doanh nghiệp đưa tài liệu nội bộ vào chatbot AI, điểm nghẽn thường không nằm ở mô hình ngôn ngữ mà nằm ở dữ liệu đầu vào. PDF bị vỡ bố cục, Word chứa định dạng ẩn, Excel có bảng khó tách nghĩa, PowerPoint lại trộn văn bản với hình ảnh. Khi dữ liệu còn nhiễu, RAG rất dễ truy xuất sai đoạn, trả lời thiếu ngữ cảnh hoặc tạo cảm giác “AI biết hết” nhưng thực tế không bám đúng tài liệu gốc.
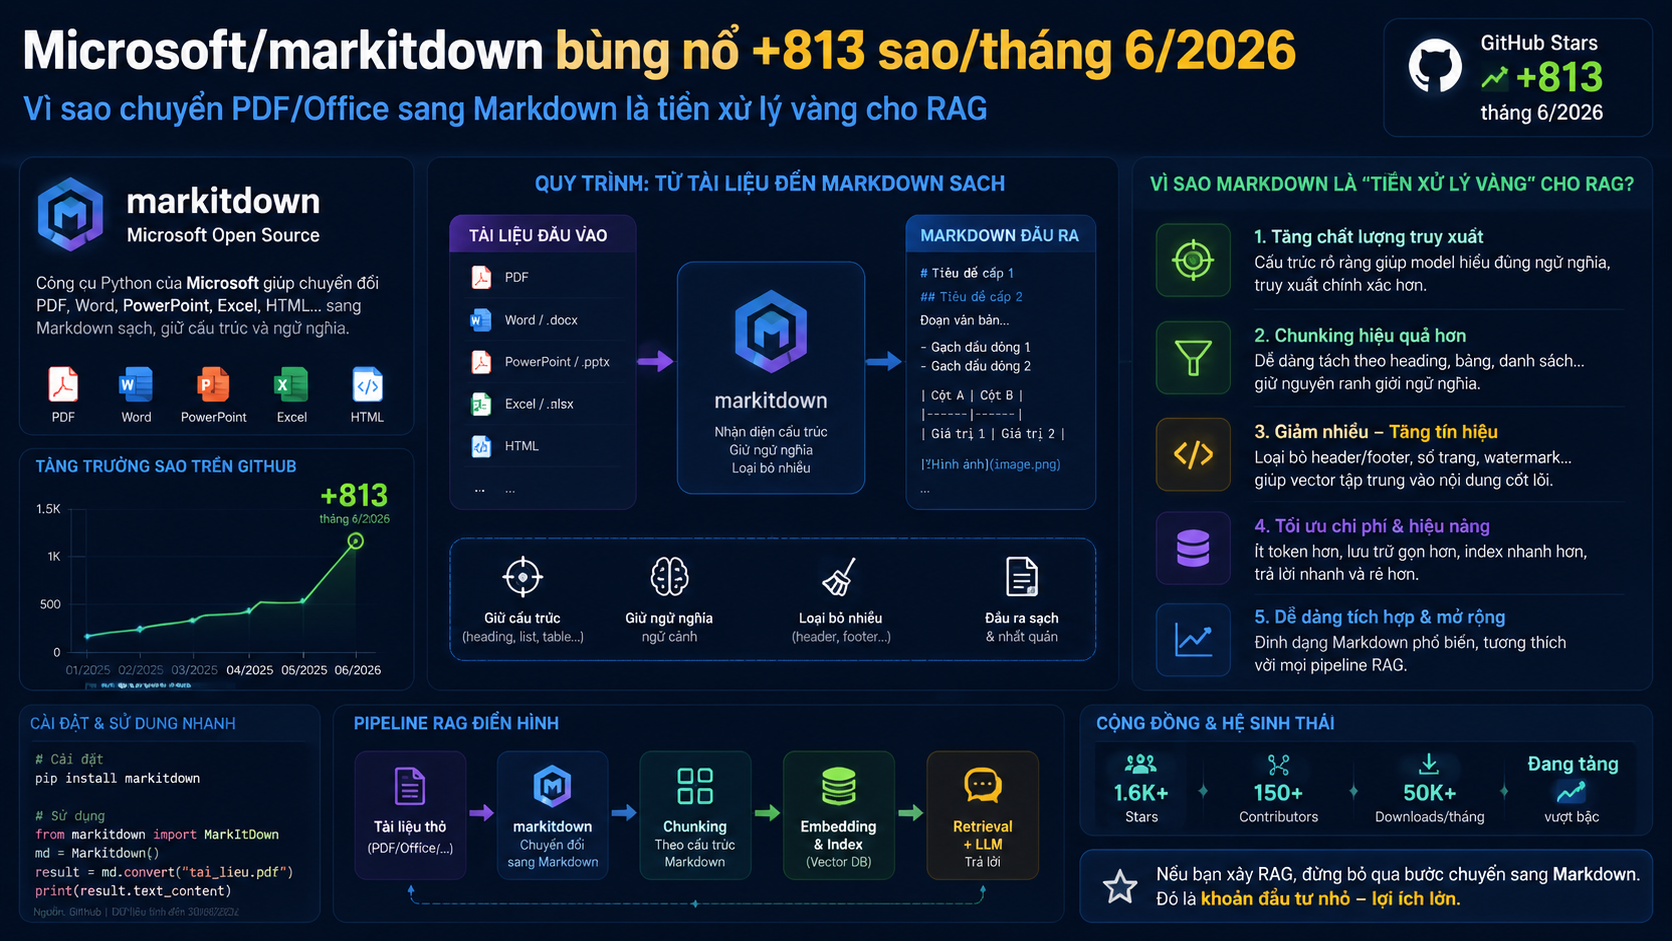
Đó là lý do microsoft/markitdown được cộng đồng kỹ thuật chú ý mạnh trong tháng 6/2026. Tín hiệu +813 sao/tháng nên được hiểu như một mốc quan sát tăng trưởng tại thời điểm theo dõi, vì số sao GitHub thay đổi liên tục và cần kiểm tra lại bằng các nguồn như Star History. Điểm quan trọng hơn con số là nhu cầu rất thật: biến PDF, Office và nhiều loại file khác thành Markdown sạch, có cấu trúc, dễ đưa vào pipeline LLM và RAG.
Tóm tắt meta-worthy: microsoft/markitdown giúp chuẩn hóa tài liệu PDF/Office sang Markdown, tạo lớp tiền xử lý gọn, dễ kiểm soát và đáng tin cậy hơn cho hệ thống RAG doanh nghiệp. Nguồn tham khảo: Centrix.
Topic & Keywords: Bài viết đang giải quyết vấn đề gì?
Chủ đề trung tâm
Bài viết này giải thích vì sao microsoft/markitdown không chỉ là một công cụ chuyển đổi định dạng, mà là một mảnh ghép quan trọng trong chuỗi tiền xử lý dữ liệu cho RAG. Với doanh nghiệp, câu hỏi không còn là “có dùng AI không”, mà là “dữ liệu nội bộ đã đủ sạch để AI sử dụng chưa”.
Ở lớp kỹ thuật, MarkItDown nằm trước các bước chunking, embedding và lưu trữ vector. Ở lớp kinh doanh, nó giúp rút ngắn khoảng cách giữa tài liệu thô và sản phẩm AI có thể vận hành: chatbot nội bộ, trợ lý bán hàng, kho tri thức sản phẩm hoặc hệ thống hỏi đáp quy trình.
Cụm từ khóa chính và phụ
Từ khóa chính của bài là microsoft/markitdown. Các cụm từ khóa phụ nên được triển khai tự nhiên theo cụm ý định: chuyển PDF sang Markdown, Office sang Markdown, MarkItDown Python, RAG pipeline, chunking, embedding, vector database, OCR tài liệu và Markdown cho LLM.
Với CentriX.digital, cụm từ khóa thương mại nên xuất hiện ở vai trò hỗ trợ, không lấn át nội dung chuyên môn: tài khoản AI, Microsoft 365, công cụ năng suất, phần mềm bản quyền và giải pháp hạ tầng số. Cách tiếp cận đúng là cho thấy CentriX không chỉ bán công cụ, mà giúp người dùng biến ý tưởng thành quy trình AI hoàn chỉnh.
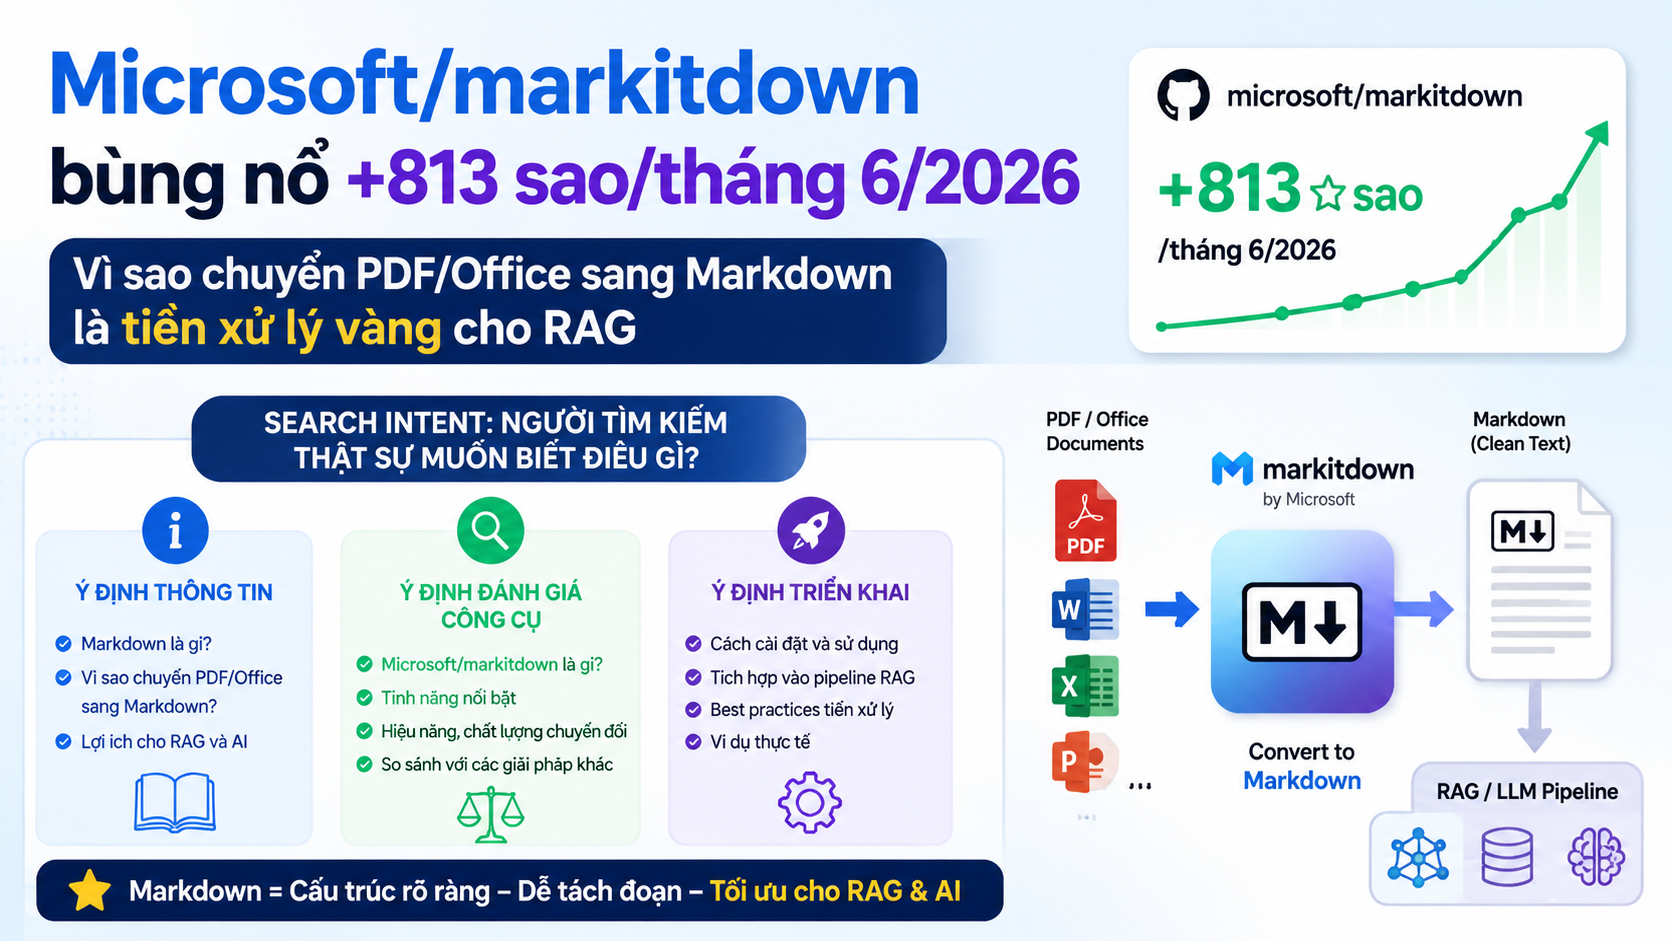
Search Intent: Người tìm kiếm thật sự muốn biết điều gì?
Ý định thông tin
Người tìm kiếm thường bắt đầu bằng câu hỏi: MarkItDown là gì? Theo kho GitHub chính thức của microsoft/markitdown, đây là công cụ Python dùng để chuyển đổi file và tài liệu Office sang Markdown. Trên PyPI, gói markitdown cũng được mô tả như một tiện ích chuyển nhiều loại file sang Markdown, có thể dùng qua Python API hoặc dòng lệnh.
Điểm cần nhấn mạnh: MarkItDown không phải LLM, không phải vector database và không tự tạo chatbot. Nó là lớp chuẩn hóa tài liệu trước khi dữ liệu đi vào các bước AI phía sau.
Ý định đánh giá công cụ
Độc giả kỹ thuật sẽ muốn biết công cụ này có đáng đưa vào pipeline thật hay không. Câu trả lời phụ thuộc vào loại tài liệu, yêu cầu bảo mật và mức độ phức tạp của layout. Với tài liệu văn phòng phổ biến như DOCX, PPTX, XLSX, PDF text, HTML hoặc CSV, hướng chuyển sang Markdown có lợi thế lớn vì giữ được phần nào cấu trúc ngữ nghĩa: heading, danh sách, bảng và liên kết.
Tuy nhiên, với PDF scan, hóa đơn mờ, tài liệu nhiều cột hoặc slide nặng hình ảnh, MarkItDown cần được kết hợp với OCR hoặc dịch vụ nhận dạng tài liệu chuyên dụng. Đây là điểm mà người triển khai production phải kiểm thử thay vì chỉ nhìn vào bản demo.
Ý định triển khai
Nhóm có nhu cầu triển khai muốn một quy trình rõ ràng: kiểm kê tài liệu, chuyển sang Markdown, làm sạch, chia chunk, gắn metadata, tạo embedding, lưu vào vector database và kiểm thử bằng câu hỏi thật. Đây cũng là khoảng trống nội dung mà nhiều bài giới thiệu công cụ chưa đi đủ sâu.
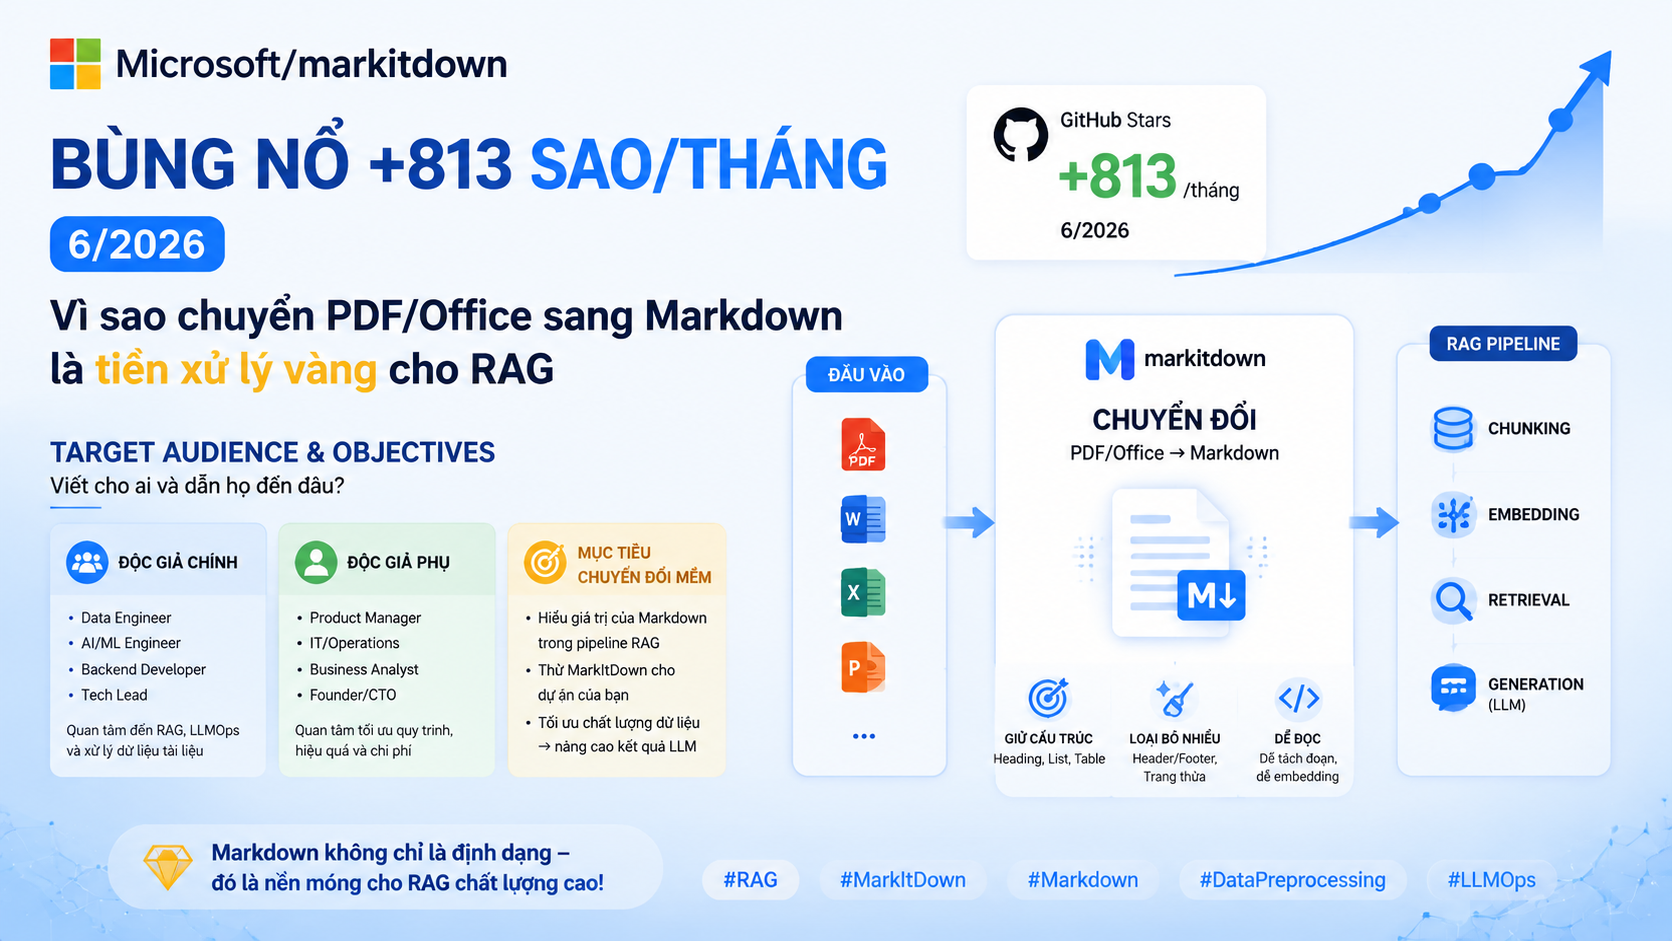
Target Audience & Objectives: Viết cho ai và dẫn họ đến đâu?
Độc giả chính
Bài viết phù hợp với kỹ sư AI, developer Python, data engineer, IT manager, chủ doanh nghiệp, freelancer automation và đội nội dung đang cần tái sử dụng tài liệu thành tri thức có cấu trúc. Điểm chung của họ là đều đang sở hữu nhiều file, nhưng chưa chắc đã có dữ liệu sạch.
Ví dụ thực tế: một công ty có 300 file Word về quy trình nhân sự, 50 file PDF hướng dẫn sản phẩm và hàng chục slide đào tạo. Nếu đưa trực tiếp vào chatbot, hệ thống có thể trả lời sai vì header/footer, số trang, bảng vỡ hoặc đoạn văn bị trộn thứ tự. Nếu chuyển qua Markdown rồi làm sạch, nhóm kỹ thuật có thể kiểm soát từng phần dữ liệu trước khi nhúng vào RAG.
Độc giả phụ
Độc giả phụ là người dùng CentriX.digital đang tìm kiếm ChatGPT, Claude, Gemini, Perplexity, Copilot, Super Grok, Monica, Canva Pro, Microsoft 365 hoặc các công cụ năng suất khác. Với nhóm này, thông điệp cần dễ hiểu: AI không chỉ là tài khoản mạnh, mà còn là quy trình dữ liệu đúng.
Mục tiêu chuyển đổi mềm
Mục tiêu của bài không phải ép người đọc mua ngay, mà giúp họ nhận ra bước đầu tiên để xây AI nội bộ là chuẩn hóa tài liệu. CentriX.digital có thể đồng hành ở lớp tài khoản AI, phần mềm bản quyền, công cụ sáng tạo và hạ tầng số để biến tài liệu thô thành báo cáo, chatbot, kho tri thức hoặc workflow vận hành.
Bối cảnh tháng 6/2026: Vì sao microsoft/markitdown được chú ý?
Tín hiệu tăng trưởng từ cộng đồng mã nguồn mở
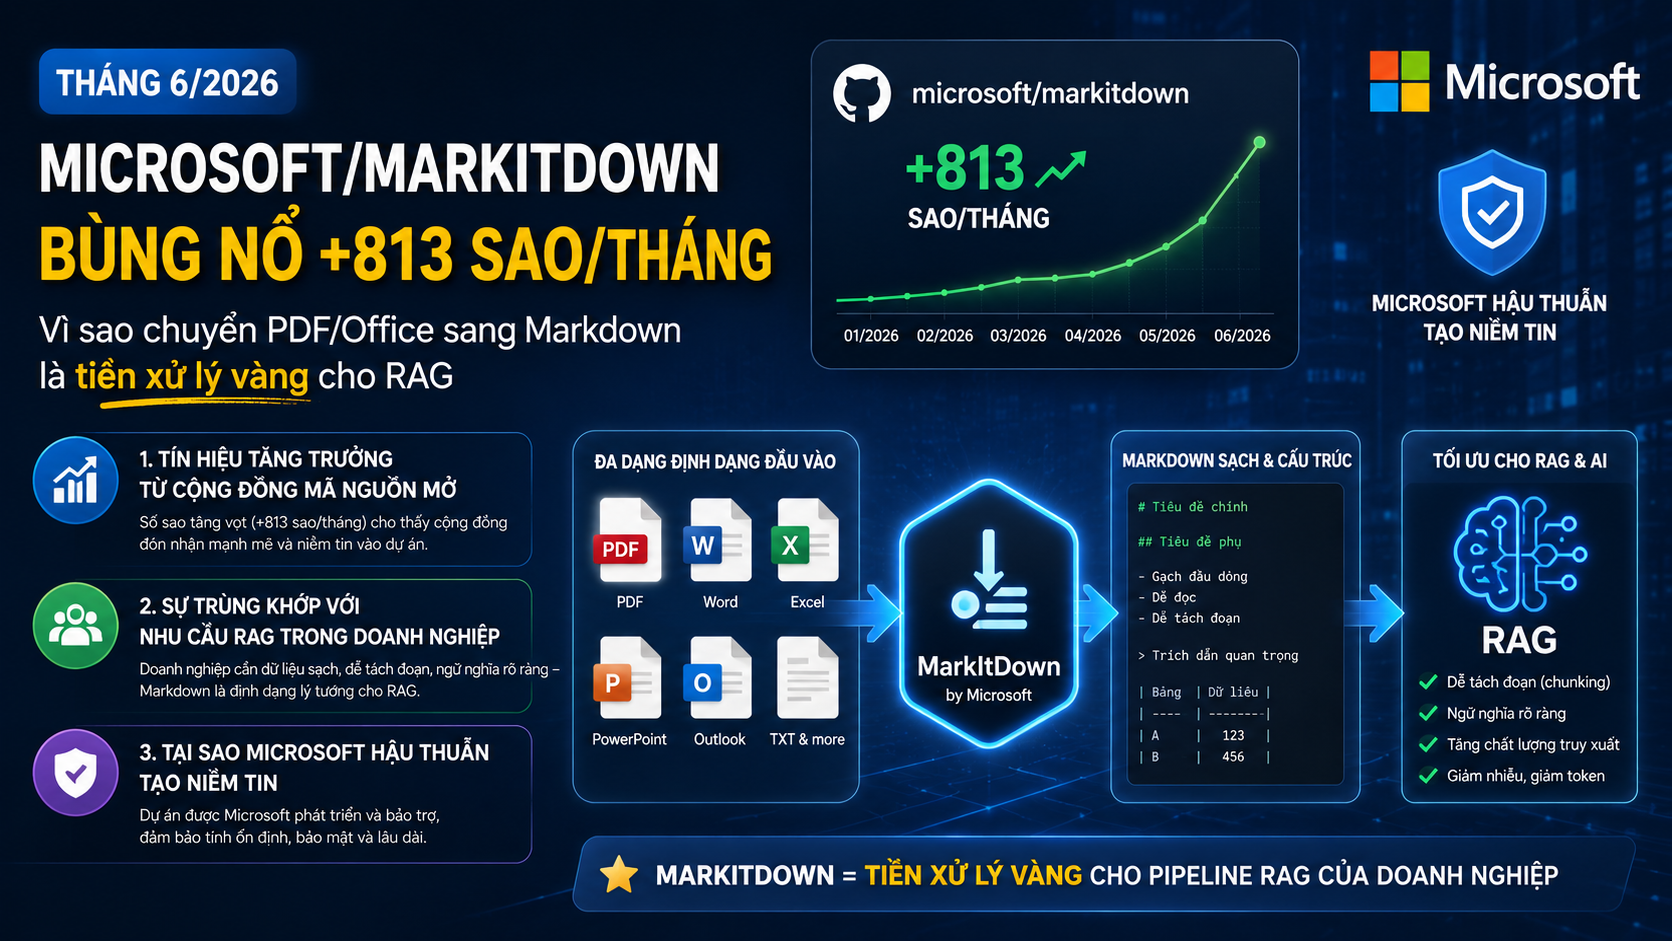
Sự quan tâm quanh microsoft/markitdown phản ánh một xu hướng rộng hơn: cộng đồng AI đang chuyển trọng tâm từ “chọn mô hình nào” sang “chuẩn bị dữ liệu thế nào”. Các trang theo dõi như Star History cho thấy repository này đang có mức tăng trưởng đáng chú ý, nhưng số sao, số fork hoặc thứ hạng chỉ nên được xem là tín hiệu tham khảo, không phải bằng chứng duy nhất về chất lượng kỹ thuật.
Sự trùng khớp với nhu cầu RAG trong doanh nghiệp
Khi doanh nghiệp triển khai RAG, họ thường phát hiện dữ liệu nội bộ không hề sẵn sàng cho AI. Tài liệu được viết cho con người đọc, không phải cho hệ thống truy xuất. Markdown trở thành lớp trung gian hợp lý vì vừa đủ gần với văn bản tự nhiên, vừa giữ được cấu trúc cần thiết để máy xử lý.
Góc nhìn triển khai: “Một pipeline RAG tốt không bắt đầu từ vector database, mà bắt đầu từ việc làm cho tài liệu đủ sạch, đủ có cấu trúc và đủ truy vết nguồn.”
Tại sao Microsoft hậu thuẫn tạo niềm tin
Yếu tố Microsoft giúp MarkItDown có độ tin cậy ban đầu trong mắt developer, đặc biệt vì công cụ được công khai trên GitHub và có package trên PyPI. Dù vậy, khi đưa vào môi trường doanh nghiệp, đội kỹ thuật vẫn cần đọc README, kiểm tra dependency, test với file thật và rà soát chính sách bảo mật dữ liệu.
MarkItDown là gì? Hiểu đúng trước khi đưa vào RAG
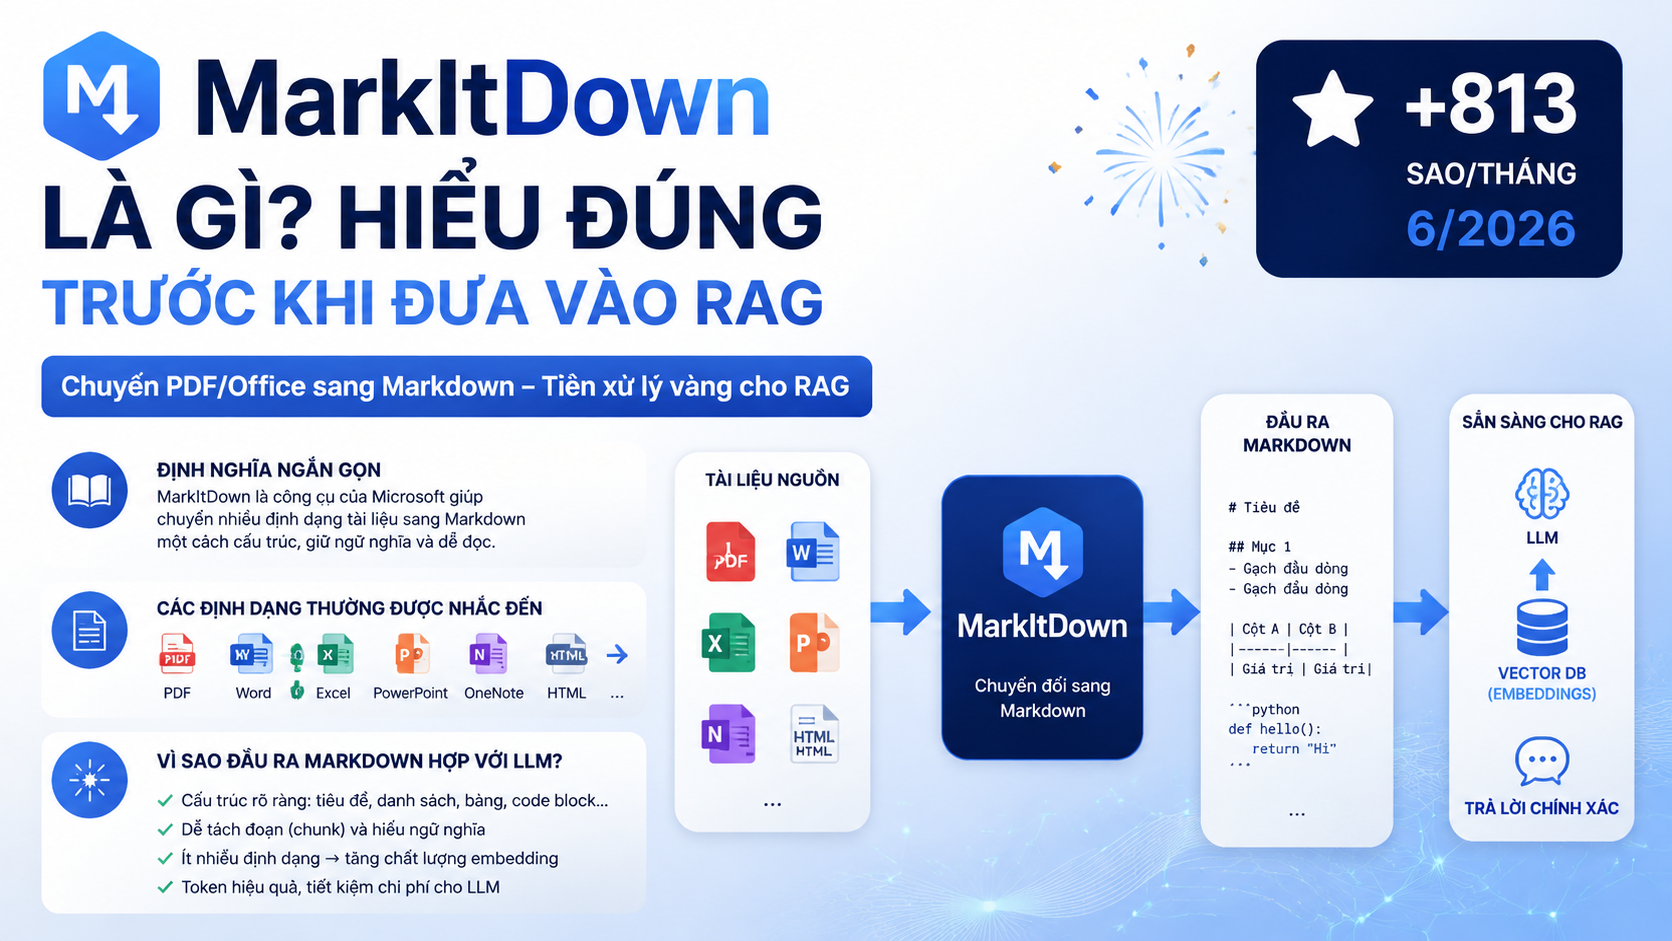
Định nghĩa ngắn gọn
MarkItDown là công cụ Python và CLI chuyển nhiều loại tài liệu sang Markdown để phục vụ indexing, phân tích văn bản và pipeline LLM/RAG. Nói cách khác, microsoft/markitdown giúp đưa tài liệu về một dạng văn bản nhẹ, dễ đọc, dễ kiểm tra và dễ chia nhỏ hơn.
Các định dạng thường được nhắc đến
Theo tài liệu chính thức và gói cài đặt hiện tại, MarkItDown hướng đến nhiều loại nguồn như PDF, tài liệu Office, HTML, CSV, JSON, XML, hình ảnh, âm thanh và một số nguồn khác tùy cấu hình. Danh sách hỗ trợ có thể thay đổi theo phiên bản, vì vậy khi triển khai production, cần kiểm tra tài liệu mới nhất thay vì dựa vào bài viết cũ.
Vì sao đầu ra Markdown hợp với LLM?
Markdown có ưu điểm là giữ cấu trúc bằng ký hiệu đơn giản. Heading cho biết cấp độ nội dung, bullet thể hiện danh sách, bảng giữ quan hệ hàng-cột, liên kết giữ nguồn tham chiếu. Với RAG, những tín hiệu này giúp quá trình chunking bớt “mù ngữ cảnh” hơn so với việc cắt plain text theo số ký tự.
| Định dạng đầu vào | Vấn đề thường gặp | Lợi ích khi chuyển sang Markdown |
|---|---|---|
| Dễ mất thứ tự đọc, lẫn header/footer | Dễ làm sạch và chia đoạn theo tiêu đề | |
| Word | Nhiều định dạng ẩn, style không nhất quán | Chuẩn hóa heading, list và đoạn văn |
| Excel | Bảng khó diễn giải nếu trích xuất phẳng | Giữ cấu trúc bảng ở dạng dễ đọc hơn |
| PowerPoint | Văn bản phân tán theo slide, nhiều hình ảnh | Tách nội dung slide thành văn bản có trình tự |
So sánh MarkItDown với cách xử lý tài liệu truyền thống
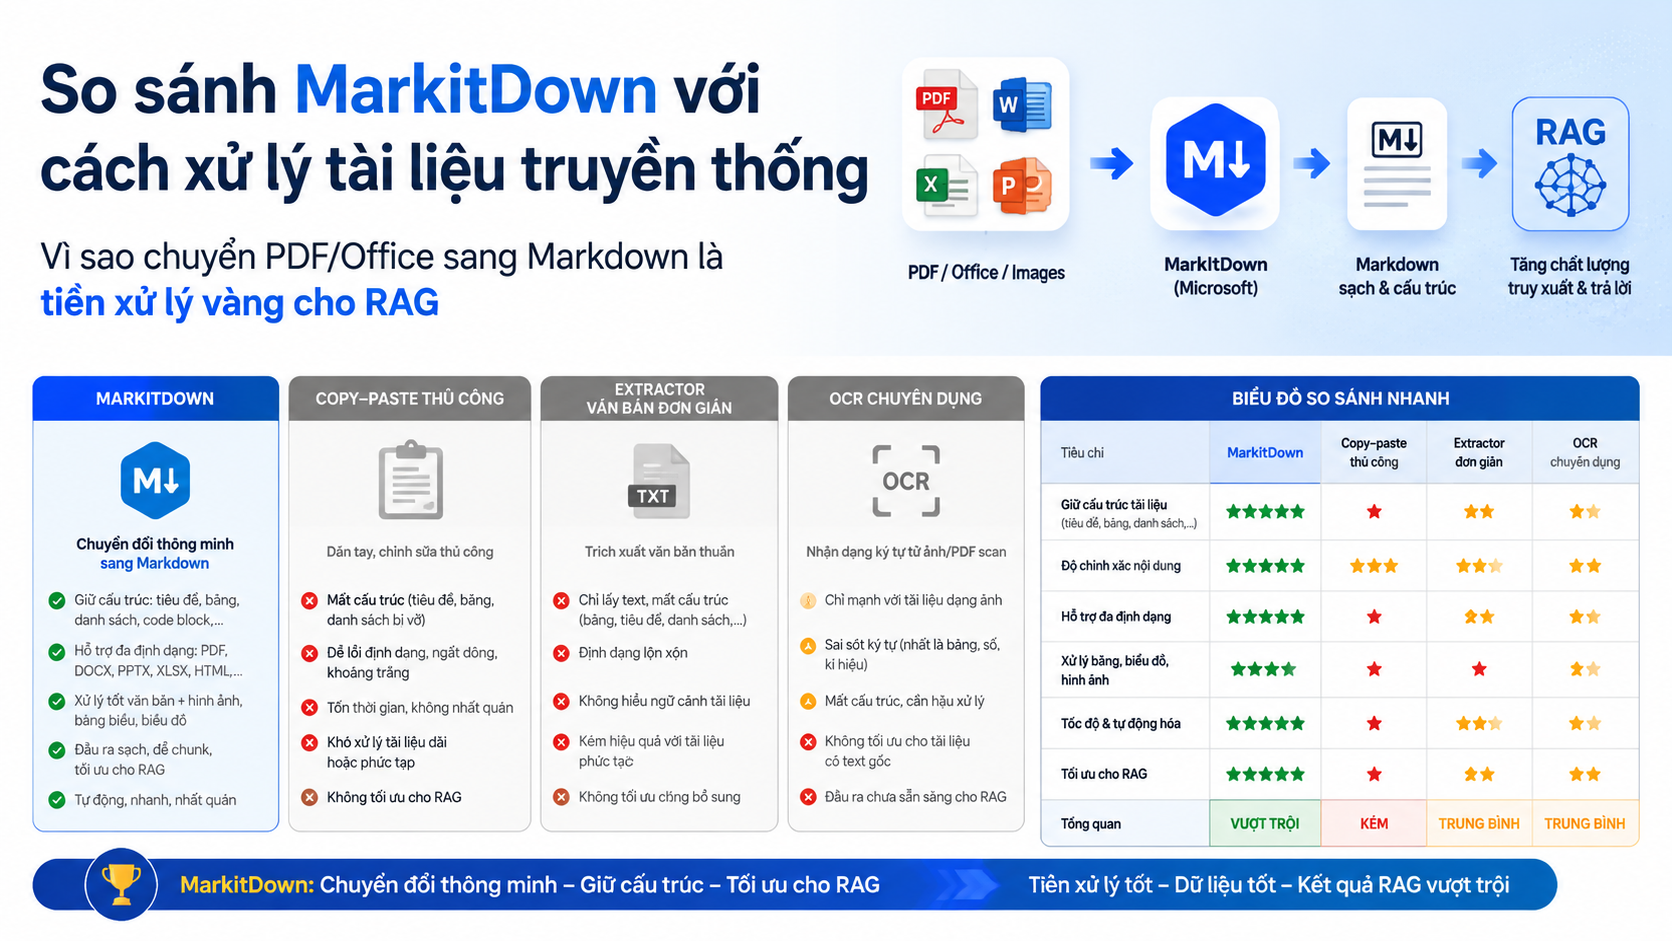
Trước khi triển khai microsoft/markitdown vào pipeline, có giá trị khi hiểu rõ điểm khác biệt giữa tiếp cận này và các cách xử lý tài liệu truyền thống. Điều này giúp đội kỹ thuật chọn công cụ phù hợp theo bối cảnh, không chỉ theo xu hướng.
So với copy–paste thủ công
Copy–paste thủ công từ file văn phòng vào trình soạn thảo có thể nhanh trong những trường hợp đơn giản, nhưng với tài liệu lớn hoặc nhiều trang, việc này dễ mất cấu trúc, thiếu thống nhất và khó kiểm soát chất lượng. Với RAG, vấn đề này càng nghiêm trọng vì mỗi đoạn văn cần có ngữ cảnh rõ ràng để embedding chính xác.
So với trình extractor văn bản đơn giản
Các công cụ extract text truyền thống thường trả về văn bản phẳng, mất đi cấu trúc quan trọng như tiêu đề, danh sách hay bảng. Trong khi đó, mục tiêu của microsoft/markitdown là giữ lại cấu trúc này ở dạng Markdown để các bước tiếp theo như chunking hoặc phân loại nội dung hiệu quả hơn — điều quan trọng trong các workflow RAG chuẩn.
So với OCR chuyên dụng
MarkItDown có thể mở rộng tính năng OCR để xử lý PDF scan, hình ảnh trong slide hay file quét, nhưng nếu tài liệu chứa nhiều vùng phức tạp hoặc đồ thị, một OCR chuyên dụng như Azure Document Intelligence hoặc các dịch vụ chuyên xử lý layout sẽ mang lại chất lượng cao hơn. Ở đây, MarkItDown thường đóng vai trò đầu tiên để đưa mọi thứ vào Markdown rồi các công cụ khác xử lý sâu hơn.
Biểu đồ so sánh nhanh
| Phương pháp | Giữ cấu trúc | Dễ kiểm soát | Tối ưu cho RAG |
|---|---|---|---|
| Copy–paste thủ công | Thấp | Thấp | Không |
| Text extractor đơn giản | Rất thấp | Trung bình | Hạn chế |
| OCR chuyên dụng | Cao | Trung bình | Có khi phù hợp |
| microsoft/markitdown | Cao | Cao | Rất phù hợp |
Use case thực tế cho doanh nghiệp và người dùng CentriX.digital
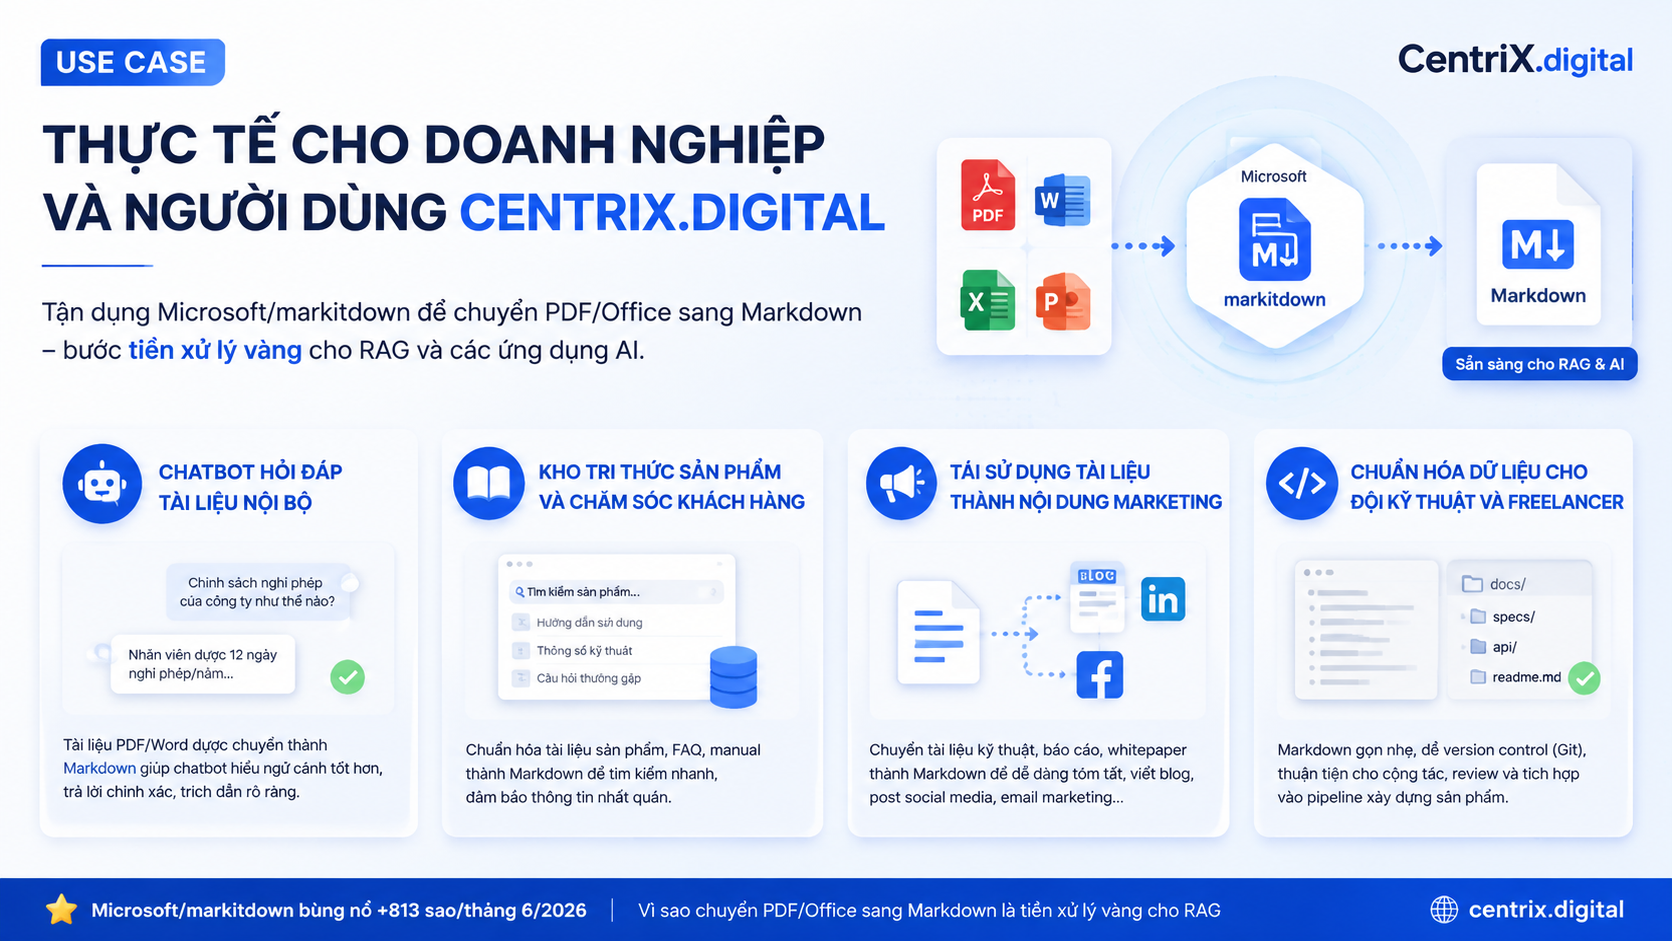
Một khi hiểu được giá trị của việc chuẩn hóa tài liệu, tiếp theo là xem xét cách microsoft/markitdown có thể áp dụng trong môi trường doanh nghiệp thật. Dưới đây là một số tình huống tiêu biểu.
Chatbot hỏi đáp tài liệu nội bộ
Công ty có bộ quy trình nhân sự, SOP, chính sách bán hàng bằng nhiều định dạng file có thể dùng MarkItDown để biến tất cả sang Markdown. Sau đó, nội dung Markdown được chia chunk và embedding lưu vào vector database để chatbot trả lời chính xác các câu hỏi nhân viên thường nhắc tới.
Kho tri thức sản phẩm và chăm sóc khách hàng
Đội sales và CSKH thường cần truy cập catalogue, bảng giá, tài liệu kỹ thuật. Bằng cách cấu trúc và chuẩn hóa dữ liệu sang Markdown trước, họ có thể xây chatbot RAG trả lời truy vấn khách hàng nhanh và chính xác hơn.
Tái sử dụng tài liệu thành nội dung marketing
Markdown hợp với hầu hết công cụ content vì hỗ trợ tiêu đề, bullet, bảng và mã. Nhóm nội dung có thể dùng Markdown để tạo blog, email hoặc video kịch bản một cách nhanh chóng hơn so với xử lý file gốc Word/PDF.
Chuẩn hóa dữ liệu cho đội kỹ thuật và freelancer
Các freelancer hoặc agency triển khai RAG cho khách hàng SME đều tìm cách giảm thời gian tiền xử lý. MarkItDown giúp họ xây quy trình chuẩn, từ việc nhận tài liệu khách hàng đến chuyển sang Markdown sạch cho indexing và phát triển ứng dụng AI.
Rủi ro, giới hạn và checklist trước khi dùng production
Dù microsoft/markitdown hữu ích, không nên xem nó như một “viên đạn bạc”. Ở sản xuất, một số vấn đề cần lưu ý để tránh lỗi vận hành hoặc mất dữ liệu quan trọng.
Bảo mật và quyền truy cập file
MarkItDown thực hiện I/O bằng quyền của tiến trình đang chạy, nên khi xử lý tài liệu nhạy cảm, hãy chạy trong môi trường kiểm soát, giới hạn quyền truy cập nhằm tránh rủi ro dữ liệu bị lộ cho các tiến trình khác.
Không phải file nào cũng chuyển hoàn hảo
Tài liệu phức tạp như bảng lớn, biểu đồ, hoặc layout đa cột có thể không được chuyển chính xác hoàn toàn. Việc kiểm tra thủ công Markdown sau khi chuyển đổi vẫn là bước quan trọng nếu dữ liệu cần độ chính xác cao cho RAG.
Cần đánh giá bằng bộ câu hỏi thực tế
Đừng chỉ tin khi Markdown “trông sạch” — cần kiểm thử bằng truy vấn mẫu để xem kết quả trả lời có sát nội dung gốc hay không. Điều này giúp điều chỉnh chunking, metadata và các tham số embedding.
Checklist triển khai
- Xác định loại tài liệu và yêu cầu bảo mật.
- Chọn môi trường chạy (local, container, cloud có kiểm soát).
- Quy định plugin OCR nếu cần xử lý file scan.
- Chuẩn hóa metadata (nguồn, ngày, tác giả).
- Thiết kế chiến lược chunking dựa trên heading và cấu trúc nội dung.
- Tạo test set câu hỏi để kiểm thử sau embedding.
Các câu hỏi thường gặp (FAQ)
microsoft/markitdown là gì?
microsoft/markitdown là công cụ Python mã nguồn mở của Microsoft giúp chuyển nhiều định dạng file như PDF, Word, Excel hay PowerPoint sang Markdown có cấu trúc — phù hợp cho các pipeline LLM và RAG.
Tại sao Markdown phù hợp với RAG?
Markdown giữ lại cấu trúc nội dung như tiêu đề, danh sách và bảng, giúp các bước chunking và embedding hoạt động hiệu quả hơn so với plain text phẳng, từ đó cải thiện chất lượng truy xuất cho hệ thống RAG.
MarkItDown có thay thế OCR không?
MarkItDown có thể dùng plugin OCR để xử lý văn bản trong hình ảnh, nhưng với tài liệu scan khó hoặc layout phức tạp, nên kết hợp với dịch vụ OCR chuyên dụng để đạt hiệu quả tốt nhất.
Có nên dùng MarkItDown cho tài liệu doanh nghiệp mật không?
Có thể dùng, nhưng cần chạy trong môi trường kiểm soát, đảm bảo quyền truy cập file và tránh gửi dữ liệu qua dịch vụ bên ngoài nếu chưa được phê duyệt bởi bộ phận bảo mật.
Kết luận và bước tiếp theo
Trong bối cảnh RAG và AI ngày càng phổ biến, chất lượng dữ liệu đầu vào là yếu tố quyết định sự thành bại của dự án. microsoft/markitdown là công cụ hữu ích để chuyển tài liệu phức tạp sang Markdown có cấu trúc, tạo nền tảng vững chắc cho quy trình chunking, embedding và truy xuất chính xác.
Nếu bạn đang xây dựng chatbot dữ liệu nội bộ, kho tri thức sản phẩm, hoặc ứng dụng RAG cho doanh nghiệp, bắt đầu bằng việc chuẩn hóa tài liệu là bước thiết yếu. CentriX.digital có thể hỗ trợ bạn với tài khoản AI chất lượng và công cụ năng suất phù hợp, giúp rút ngắn khoảng cách giữa ý tưởng và sản phẩm AI hoàn chỉnh.