
Nhu cầu dùng AI để đọc hồ sơ, đối chiếu tài liệu, phân tích mã nguồn và duy trì lịch sử dự án ngày càng lớn. Vì vậy, gpt-6 astra context window cùng mốc 1,05 triệu token dễ thu hút sự chú ý của người dùng đang tìm một mô hình AI ngữ cảnh dài.
Nếu được xác nhận, dung lượng này có thể giúp mô hình tiếp nhận nhiều dữ liệu hơn trong một phiên, giảm công việc chia nhỏ tài liệu. Tuy nhiên, số token lớn không tự động bảo đảm câu trả lời chính xác, khả năng suy luận tốt hoặc chi phí sử dụng hợp lý.
Bài viết phân tích bản chất kỹ thuật, cách kiểm chứng thông tin và tiêu chí so sánh thực tế. Tên gọi GPT-6 Astra, giới hạn 1,05 triệu token, phiên bản hỗ trợ và điều kiện truy cập vẫn cần được đối chiếu với tài liệu sản phẩm hiện hành trước khi xem là dữ kiện chính thức.
Mục lục bài viết
GPT-6 Astra context window là gì?
Context window, hay cửa sổ ngữ cảnh, là tổng phạm vi thông tin mô hình có thể tiếp nhận và xử lý trong một lượt hoặc phiên làm việc. Phạm vi này có thể gồm chỉ dẫn hệ thống, câu hỏi, lịch sử hội thoại, tài liệu, dữ liệu công cụ và phần phản hồi, tùy cách nhà cung cấp tính giới hạn.
Câu trả lời ngắn: context window xác định lượng thông tin AI có thể xem xét tại thời điểm tạo phản hồi. Nó không phải bộ nhớ vĩnh viễn, không đại diện cho toàn bộ kiến thức của mô hình và không chứng minh mô hình sẽ hiểu đúng mọi chi tiết đã nhận.
Với mốc 1,05 triệu token đang được nhắc đến, điểm đáng quan tâm không chỉ là dung lượng. Người dùng còn phải đánh giá mô hình có tìm đúng bằng chứng, kết nối thông tin xa nhau, duy trì tính nhất quán và phản hồi trong giới hạn thời gian, chi phí chấp nhận được hay không.
Tên gọi GPT-6 Astra và mốc 1,05 triệu token cần được xác minh ra sao?
Một tên mô hình xuất hiện trên bài đăng cộng đồng, video giới thiệu hoặc trang của đơn vị trung gian chưa đủ để xác nhận nguồn gốc sản phẩm. Thứ tự ưu tiên kiểm tra nên là thông báo của đơn vị phát hành, tài liệu kỹ thuật, trang sản phẩm, tài liệu API, sau đó mới đến nguồn phân phối và nội dung cộng đồng.
Khi gặp tuyên bố về 1,05 triệu token, cần ghi nhận thời điểm kiểm tra, tên phiên bản, nền tảng truy cập và gói tài khoản. Cùng một mô hình có thể có giới hạn khác nhau giữa giao diện web, API hoặc dịch vụ do bên thứ ba cung cấp.
- Xác minh đơn vị phát hành và tên mô hình chính xác.
- Kiểm tra giới hạn có tính cả đầu vào lẫn đầu ra hay không.
- Đối chiếu loại tệp, dung lượng tải lên và điều kiện theo gói.
- Không suy diễn kiến trúc, ngày phát hành, giá hoặc hiệu năng khi thiếu nguồn trực tiếp.
Trong khi chưa có tài liệu đáng tin cậy, cách diễn đạt phù hợp là “mốc được tuyên bố” hoặc “thông tin cần xác minh”. Cách này tách rõ phân tích kỹ thuật khỏi việc xác nhận một sản phẩm cụ thể.
Context window khác bộ nhớ dài hạn như thế nào?
Cửa sổ ngữ cảnh là vùng làm việc tạm thời cho lần xử lý hiện tại. Khi cuộc trò chuyện vượt giới hạn, phần nội dung cũ có thể bị loại bỏ, rút gọn hoặc không còn được mô hình sử dụng trực tiếp.
Bộ nhớ hội thoại là tính năng lưu một số thông tin qua nhiều phiên nếu nền tảng hỗ trợ. Dữ liệu huấn luyện là kiến thức hình thành trong quá trình đào tạo, còn dữ liệu truy xuất bên ngoài được lấy từ tệp, công cụ tìm kiếm hoặc hệ thống RAG tại thời điểm sử dụng.
Ví dụ, một nhóm thảo luận dự án qua hàng trăm lượt có thể đã nêu yêu cầu quan trọng ở đầu cuộc trò chuyện. Nếu yêu cầu đó rời khỏi vùng ngữ cảnh và không được lưu bằng cơ chế khác, mô hình có thể trả lời như thể thông tin chưa từng xuất hiện.
1,05 triệu token thực sự có ý nghĩa gì?
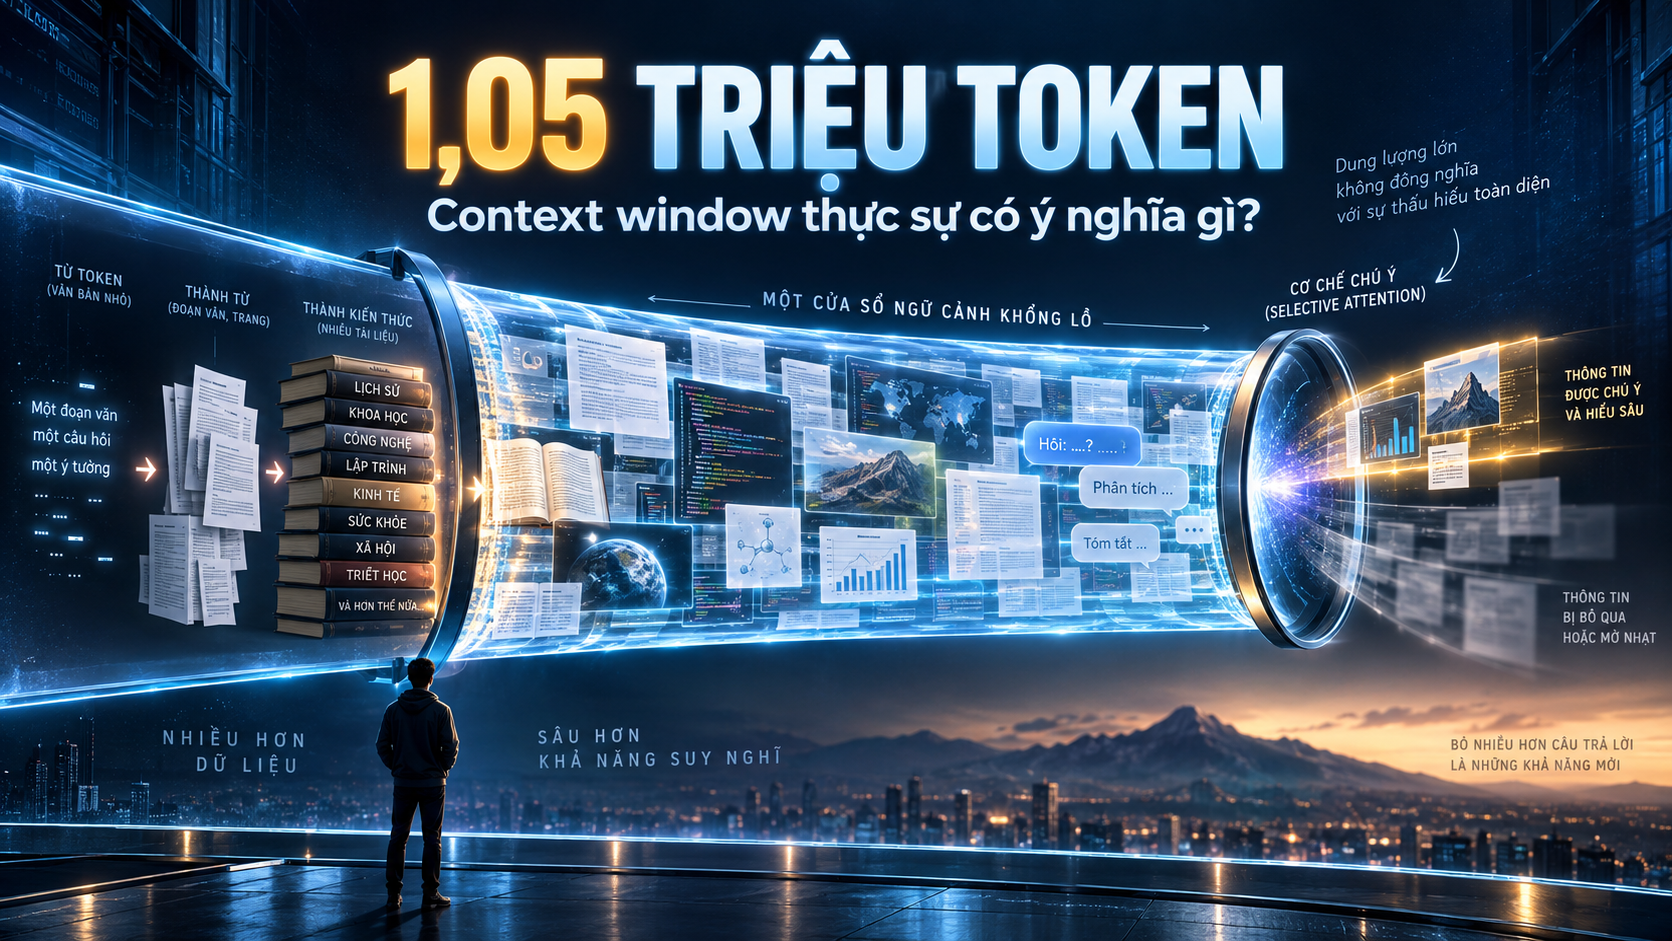
Token là đơn vị biểu diễn dữ liệu mà mô hình xử lý, không tương ứng cố định với một từ, ký tự hoặc trang. Một từ có thể thành một token hoặc nhiều token; dấu câu, khoảng trắng, mã nguồn, ký hiệu và ngôn ngữ đều ảnh hưởng đến kết quả.
Do đó, 1,05 triệu token nên được hiểu là giới hạn dung lượng ngữ cảnh được công bố hoặc tuyên bố, không phải số từ cố định. Đây cũng không phải chỉ số trực tiếp về độ chính xác, khả năng lập luận hay chất lượng đầu ra.
Dung lượng thường không chỉ dành cho tài liệu người dùng tải lên. Nhiều thành phần có thể cùng chiếm giới hạn:
- Chỉ dẫn hệ thống và quy tắc vận hành.
- Câu hỏi hiện tại cùng lịch sử hội thoại.
- Nội dung tệp, bảng biểu và mã nguồn.
- Kết quả từ công cụ hoặc hệ thống truy xuất.
- Không gian dành cho câu trả lời của mô hình.
Cách tính có thể khác giữa sản phẩm, API và gói dịch vụ. Người dùng không nên giả định toàn bộ giới hạn đều dành cho đầu vào nếu tài liệu kỹ thuật chưa nói rõ.
Có thể quy đổi token thành từ hoặc số trang không?
Không có tỷ lệ quy đổi chính xác áp dụng cho mọi tài liệu. Văn bản tiếng Việt, tiếng Anh, mã lập trình, dữ liệu dạng bảng và nội dung chứa nhiều ký hiệu có thể được bộ tách token xử lý rất khác nhau.
Cách ước lượng đáng tin cậy là lấy một mẫu đại diện, đo bằng công cụ đếm token tương thích đúng mô hình, sau đó đối chiếu với toàn bộ tập dữ liệu. Khi lập ngân sách API, nên tính thêm chỉ dẫn, lịch sử hội thoại, dữ liệu công cụ và phần đầu ra dự kiến.
Số trang còn kém ổn định hơn vì phụ thuộc phông chữ, cỡ chữ, khoảng cách, hình ảnh và bố cục. Hai tài liệu cùng số trang có thể chênh lệch lớn về lượng văn bản thực tế.
Dung lượng lớn có đồng nghĩa mô hình hiểu toàn bộ nội dung không?
Không. Khả năng tiếp nhận dữ liệu chỉ cho biết nội dung có thể nằm trong phạm vi xử lý; nó không bảo đảm mô hình sẽ tìm đúng chi tiết, hiểu quan hệ giữa các phần hoặc suy luận chính xác.
Trong một tập tài liệu dài, bằng chứng quan trọng có thể bị lẫn giữa nội dung trùng lặp, lỗi thời hoặc mâu thuẫn. Chất lượng đầu ra thường phụ thuộc vào cấu trúc tài liệu, cách đặt câu hỏi, vị trí bằng chứng và yêu cầu kiểm chứng.
Ví dụ, thay vì yêu cầu “hãy tóm tắt toàn bộ hồ sơ”, người dùng có thể yêu cầu liệt kê từng kết luận kèm tên tài liệu, mục liên quan và đoạn hỗ trợ. Cách làm này tạo điều kiện kiểm tra, nhưng người dùng vẫn phải đối chiếu những thông tin quan trọng.
Cách kiểm chứng và đánh giá GPT-6 Astra trước khi sử dụng
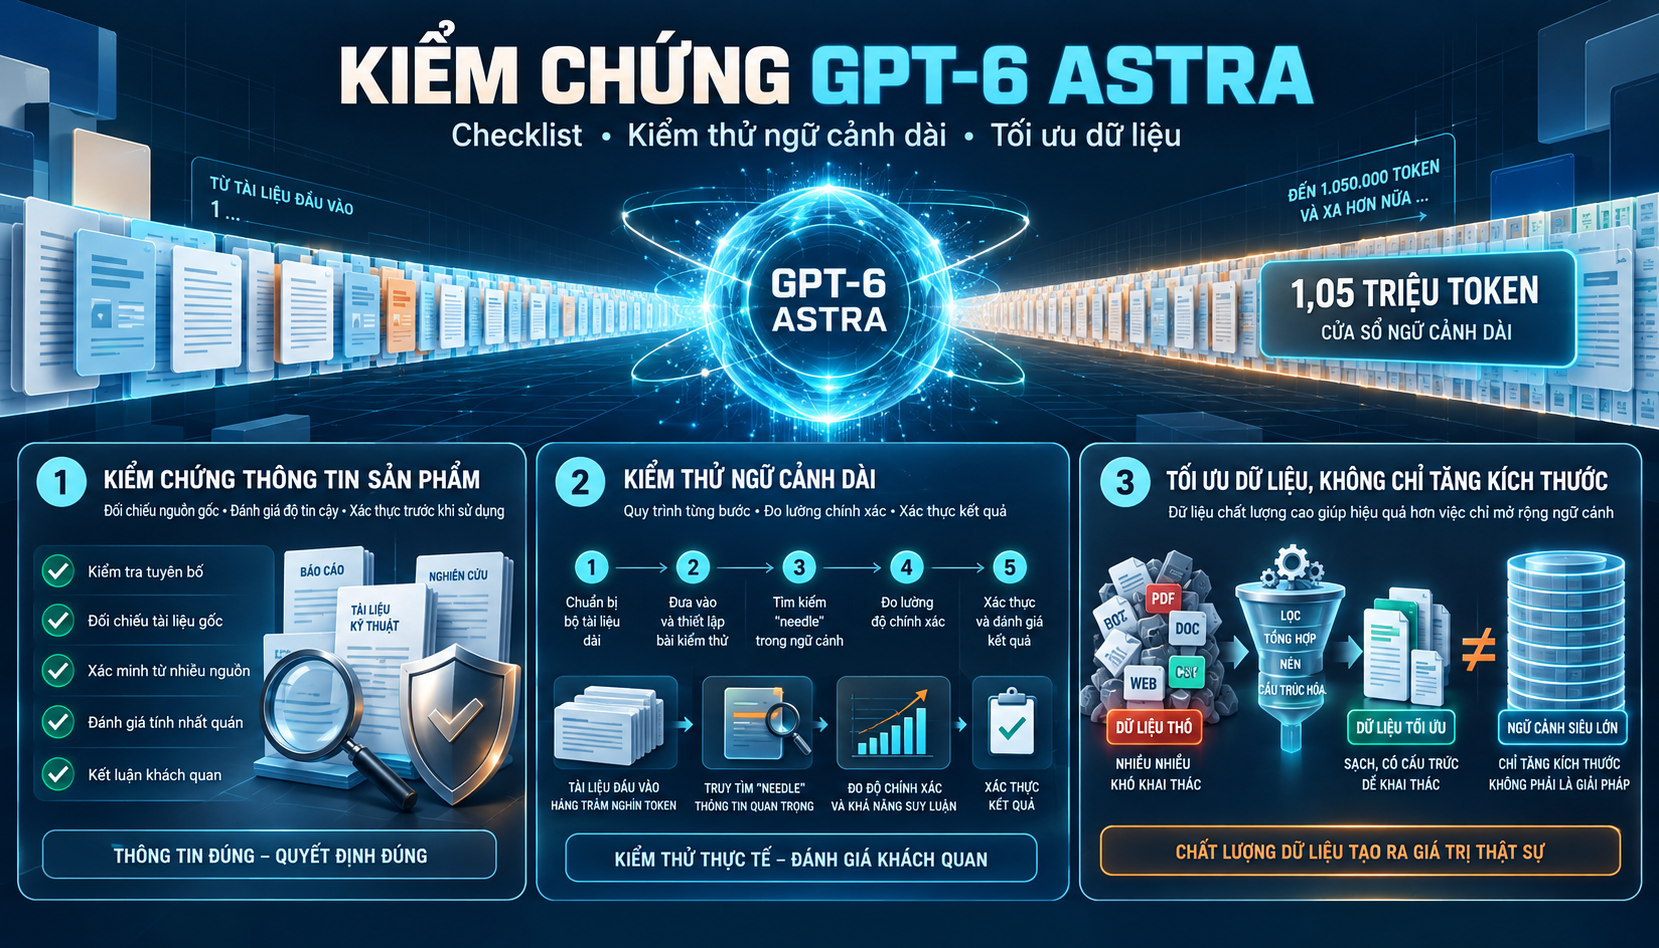
Đánh giá nên dựa trên tài liệu chính thức hiện hành và thử nghiệm có thể lặp lại, không chỉ dựa vào video trình diễn. Các tiêu chí chính gồm độ chính xác, khả năng truy vết, độ trễ, chi phí, bảo mật và mức phù hợp với quy trình.
Danh sách kiểm tra thông tin sản phẩm
- Đúng tên mô hình, phiên bản, đơn vị phát hành và kênh truy cập.
- Giới hạn ngữ cảnh có tính cả đầu ra hay được tách riêng.
- Loại tệp, dung lượng tải lên, hạn mức và điều kiện theo gói.
- Chính sách dữ liệu, quyền riêng tư, hỗ trợ và phạm vi tài khoản.
- Nguồn chính thức cùng ngày kiểm tra để phát hiện thay đổi về sau.
Nếu thiếu nguồn trực tiếp đáng tin cậy, hãy giữ trạng thái “chưa xác minh”. Không dùng bài đăng cộng đồng làm căn cứ duy nhất cho thông số sản phẩm.
Quy trình kiểm thử ngữ cảnh dài từng bước
- Chọn bộ tài liệu đại diện, đồng thời loại bỏ dữ liệu không được phép chia sẻ.
- Tạo bộ câu hỏi có đáp án biết trước, đặt thông tin kiểm tra ở đầu, giữa và cuối tập tài liệu.
- Yêu cầu câu trả lời kèm vị trí bằng chứng; cho phép mô hình nói không tìm thấy thay vì suy đoán.
- Lặp lại bài thử với lượng dữ liệu và thứ tự tệp khác nhau để đánh giá tính ổn định.
- So sánh kết quả, thời gian, chi phí và mức can thiệp thủ công trước khi triển khai.
Bài thử nên phản ánh công việc thực tế thay vì chỉ hỏi những chi tiết dễ tìm. Một mô hình phù hợp cần duy trì chất lượng ở nhiều lần chạy và giúp người dùng kiểm tra kết luận thuận tiện.
Tối ưu dữ liệu thay vì chỉ tăng context window
Hãy loại bỏ bản trùng, tệp lỗi thời, nội dung không liên quan và định dạng gây nhiễu. Tiêu đề rõ ràng, siêu dữ liệu nhất quán và quy tắc trích dẫn cụ thể giúp mô hình định vị thông tin tốt hơn.
Với kho dữ liệu lớn hơn nhu cầu của từng truy vấn, tóm tắt phân tầng, tìm kiếm hoặc RAG thường hợp lý hơn. Chỉ dẫn cũng nên yêu cầu mô hình nêu phần chưa chắc chắn và không tự điền dữ liệu còn thiếu.
Ai nên cân nhắc GPT-6 Astra context window?
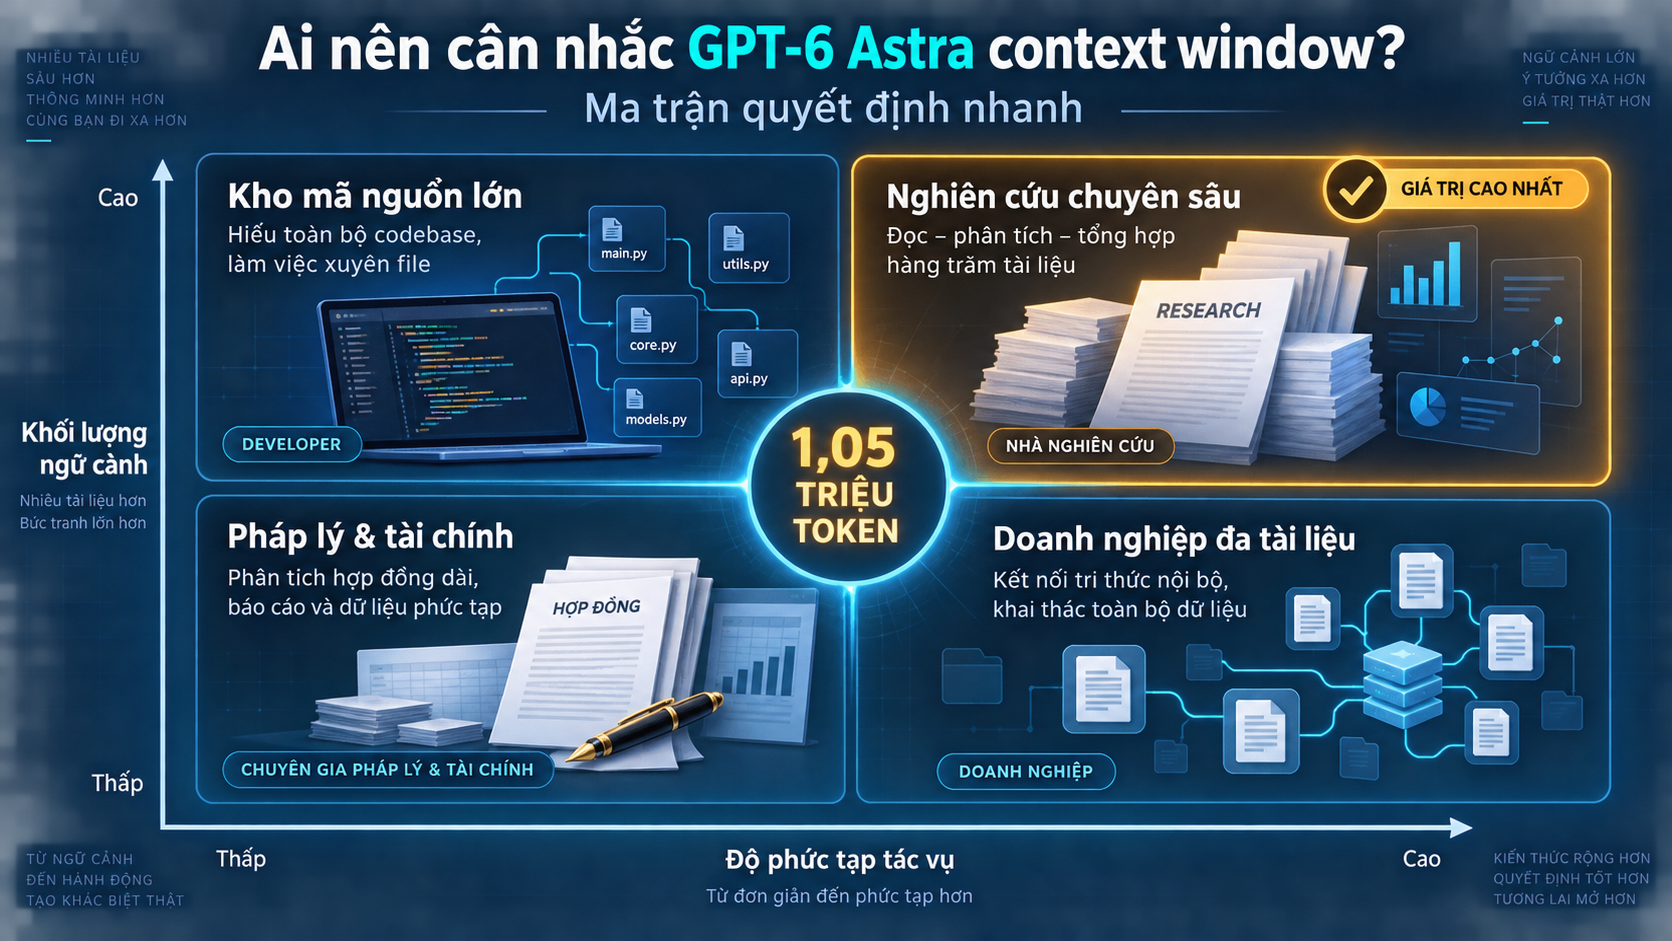
Lựa chọn này có thể phù hợp với đội phát triển xử lý nhiều tệp mã, nhóm nghiên cứu đối chiếu tài liệu, bộ phận vận hành quản lý tri thức hoặc nhà sáng tạo làm dự án dài. Người chỉ thực hiện tác vụ ngắn chưa cần ưu tiên dung lượng lớn.
Ma trận quyết định nhanh
| Đặc điểm nhu cầu | Hướng lựa chọn |
|---|---|
| Ít dữ liệu, tác vụ ngắn, hiếm khi cần nối nhiều nguồn | Dùng context tiêu chuẩn |
| Tập dữ liệu hữu hạn cần xem đồng thời, truy vết giữa nhiều phần | Cân nhắc mô hình ngữ cảnh dài |
| Kho dữ liệu lớn, thay đổi thường xuyên, cần truy xuất chọn lọc | Ưu tiên RAG hoặc kết hợp context dài |
| Dữ liệu nhạy cảm, thiếu phân quyền hoặc quy trình kiểm thử | Chưa nên triển khai |
Quyết định cuối cùng cần dựa trên thông tin sản phẩm đã xác minh, thử nghiệm nội bộ và tổng chi phí sử dụng. CentriX.digital có thể là điểm tham khảo cho tài khoản AI, phần mềm bản quyền và công cụ năng suất; khả năng cung cấp một mô hình cụ thể vẫn cần được xác nhận tại thời điểm lựa chọn.
Câu hỏi thường gặp về GPT-6 Astra context window
GPT-6 Astra có thực sự hỗ trợ 1,05 triệu token không?
Chưa nên xác nhận tuyệt đối nếu không có tài liệu trực tiếp, hiện hành từ đơn vị phát hành hoặc kênh phân phối được ủy quyền. Cần kiểm tra đúng tên phiên bản, nền tảng truy cập, gói tài khoản và cách tính đầu vào, đầu ra vì các điều kiện này có thể khác nhau.
1,05 triệu token tương đương bao nhiêu trang?
Không có phép quy đổi cố định. Số token thay đổi theo ngôn ngữ, mã nguồn, ký hiệu, bảng biểu, bố cục và bộ tách token; số trang còn phụ thuộc định dạng trình bày. Khi cần lập ngân sách, hãy đo tài liệu mẫu bằng công cụ tương thích với đúng mô hình.
Context window lớn có làm AI chính xác hơn không?
Không nhất thiết. Dung lượng lớn cho phép cung cấp thêm dữ liệu nhưng không bảo đảm mô hình dùng đúng mọi chi tiết. Chất lượng tài liệu, cấu trúc chỉ dẫn, vị trí bằng chứng và bước kiểm chứng đầu ra thường quan trọng hơn việc nạp tối đa nội dung.
Có nên tải toàn bộ tài liệu doanh nghiệp lên mô hình không?
Không nên tải mặc định. Doanh nghiệp cần phân loại dữ liệu, xác minh quyền truy cập, điều khoản lưu trữ, mục đích xử lý và yêu cầu pháp lý liên quan. Chỉ nên cung cấp phần tối thiểu cần thiết sau khi đã loại bỏ bí mật, dữ liệu cá nhân và nội dung không liên quan.
Nên chọn context window lớn hay RAG?
Context lớn phù hợp với tập dữ liệu hữu hạn cần xem đồng thời. RAG phù hợp hơn với kho dữ liệu lớn, thay đổi thường xuyên hoặc cần truy xuất có chọn lọc. Hai phương án có thể kết hợp, nhưng chỉ nên triển khai sau khi so sánh độ chính xác, khả năng truy vết và chi phí.
Giá trị thực nằm ở khả năng sử dụng
Mốc 1,05 triệu token chỉ đáng chú ý khi đi cùng khả năng truy xuất đúng, suy luận ổn định, bảo mật phù hợp và chi phí chấp nhận được. Trước khi chọn GPT-6 Astra, hãy xác minh thông tin sản phẩm, thử nghiệm bằng dữ liệu đại diện và đánh giá kết quả theo nhu cầu thực tế.
Nếu đang xây dựng quy trình AI cho cá nhân hoặc đội nhóm, có thể bắt đầu bằng việc xác định tác vụ, phân loại dữ liệu và so sánh các công cụ phù hợp. Hệ sinh thái tại CentriX.digital là một lựa chọn tham khảo để tiếp cận tài khoản AI, phần mềm bản quyền và công cụ năng suất theo mục tiêu sử dụng.
Bạn cũng có thể đọc thêm GPT-6 Astra price: Giá API bao nhiêu? Bảng giá token mới nhất để nắm bối cảnh liên quan trước khi áp dụng.
Nhìn chung, gpt-6 astra context window đang ngày càng được quan tâm vì giá trị thực tế mà gpt-6 astra context window mang lại; hiểu đúng về gpt-6 astra context window sẽ giúp bạn áp dụng gpt-6 astra context window một cách hiệu quả nhất.
Qua bài viết này, bạn đã nắm được những điểm cốt lõi về gpt-6 astra context window, từ khái niệm, lợi ích cho đến cách triển khai gpt-6 astra context window trong thực tế.
Nếu bạn muốn tìm hiểu sâu hơn về gpt-6 astra context window hoặc cần tư vấn thêm về gpt-6 astra context window, hãy theo dõi các nội dung tiếp theo của chúng tôi về gpt-6 astra context window.
Để tìm hiểu thêm, bạn có thể tham khảo hướng dẫn chính thức từ Google Search Central về các nguyên tắc tối ưu hóa nội dung cho công cụ tìm kiếm.