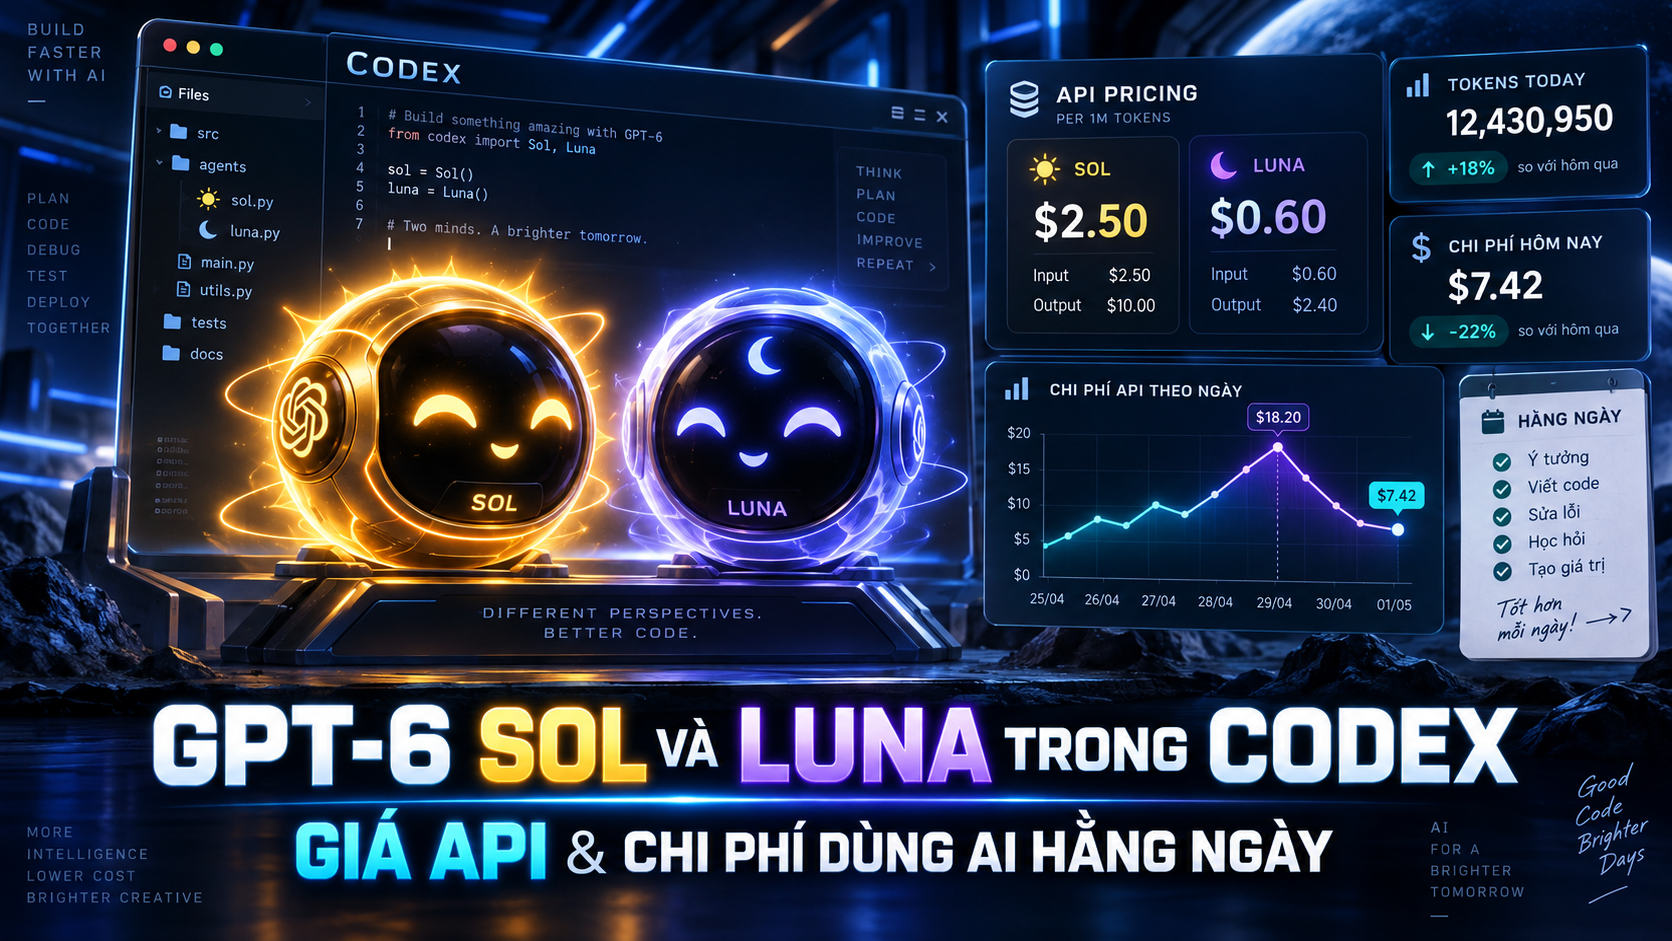

Nếu dùng AI để viết mã, đọc kho mã, sửa lỗi và vận hành agent mỗi ngày, hóa đơn API thực tế sẽ được hình thành ra sao? Với GPT‑6 Sol và Luna trong Codex, câu hỏi quan trọng không chỉ là “giá mỗi token bao nhiêu”, mà còn là model đã được xác nhận hay chưa, Codex tính phí theo cơ chế nào và một tác vụ coding cần bao nhiêu lượt xử lý.
Tại thời điểm biên tập, không nên xem tên GPT‑6 Sol hoặc GPT‑6 Luna xuất hiện trên mạng là bằng chứng về sản phẩm chính thức. Khi chưa có bảng giá và tài liệu được OpenAI công bố, mọi con số cụ thể đều có nguy cơ gây hiểu nhầm.
Vì vậy, phần đầu bài viết tập trung vào cách kiểm chứng thông tin và phương pháp tính chi phí theo token. Khung này có thể áp dụng ngay cho model hiện có, đồng thời giúp bạn cập nhật ngân sách nhanh chóng nếu Sol hoặc Luna được phát hành sau này.
Mục lục bài viết
Giá API được tính như thế nào khi dùng AI cho coding?
Cơ chế phổ biến là tính riêng token đầu vào và token đầu ra theo một đơn vị chuẩn do nhà cung cấp niêm yết. Một số dịch vụ còn tách giá token cache, công cụ, lưu trữ hoặc tài nguyên thực thi, vì vậy không nên chỉ nhìn vào một dòng “giá đầu vào”.
Tổng chi phí tác vụ = chi phí đầu vào + chi phí đầu ra + chi phí bộ nhớ đệm + phí công cụ + chi phí các lượt thử lại.
Giá niêm yết theo một lượng token chuẩn không phải là giá cho mỗi câu hỏi. Người dùng phải lấy lượng token thực tế của từng lượt gọi, quy đổi theo đơn giá tương ứng rồi cộng toàn bộ các lượt mà agent đã thực hiện.
Công thức ước tính chi phí theo token
Gọi số token đầu vào là I, đơn giá đầu vào là Pi, số token đầu ra là O và đơn giá đầu ra là Po. Nếu biểu giá được niêm yết trên M token, chi phí model có thể tính theo công thức: (I × Pi ÷ M) + (O × Po ÷ M).
Sau đó, cộng chi phí cache C, công cụ T và các khoản hạ tầng H nếu có. Công thức hoàn chỉnh là: (I × Pi ÷ M) + (O × Po ÷ M) + C + T + H.
Ví dụ, một agent nhận yêu cầu sửa lỗi có thể đọc mã nguồn ở lượt đầu, chạy kiểm thử, nhận log lỗi rồi gửi bản vá ở lượt tiếp theo. Thay vì tính đây là một yêu cầu duy nhất, cần cộng token của từng lượt đọc, phân tích, phản hồi và thử lại.
- Lấy token đầu vào và đầu ra từ nhật ký API hoặc bảng theo dõi mức dùng của nền tảng.
- Áp dụng đúng đơn giá của model được gọi tại từng lượt, kể cả khi agent tự chuyển model.
- Cộng chi phí công cụ, cache, lượt lỗi và lượt thử lại.
- Chia tổng chi phí cho số tác vụ hoàn thành để có chi phí trung bình mỗi tác vụ.
- Nhân với số tác vụ mỗi ngày và số ngày sử dụng để lập ngân sách tháng.
Không có tỷ lệ cố định giữa số từ và số token cho mọi ngôn ngữ, loại mã hoặc model. Vì thế, bộ đếm ước lượng chỉ phù hợp để dự báo; nhật ký sử dụng thực tế vẫn là dữ liệu đáng tin cậy hơn khi chốt ngân sách.
Nếu thanh toán quốc tế, tổng tiền cuối cùng còn có thể chịu ảnh hưởng của thuế, tỷ giá, phí nền tảng hoặc ngưỡng thanh toán tối thiểu. Chỉ cộng các khoản này khi nhà cung cấp hoặc đơn vị thanh toán thực sự công khai áp dụng.
Những thành phần dễ bị bỏ sót trong hóa đơn
Thành phần đầu tiên là lịch sử hội thoại. Nếu toàn bộ cuộc trao đổi được gửi lại ở mỗi lượt, đầu vào sẽ tăng dần ngay cả khi câu hỏi mới chỉ dài một dòng.
Thứ hai là phạm vi kho mã. Agent đọc nhiều thư mục, tài liệu, tệp cấu hình và log sẽ tiêu thụ ngữ cảnh lớn hơn một trợ lý chỉ xử lý đoạn mã được chọn.
Thứ ba là vòng lặp tự sửa. Một Coding Agent có thể viết mã, chạy test, phát hiện lỗi, chỉnh sửa và chạy lại nhiều lần; mỗi vòng đều có thể phát sinh token và tài nguyên thực thi.
Đầu ra dư thừa cũng là nguồn tốn kém phổ biến. Việc yêu cầu model in lại toàn bộ tệp, mô tả từng dòng hoặc tạo báo cáo dài không cần thiết có thể làm chi phí cao hơn mà không cải thiện chất lượng bản vá.
Cuối cùng là hạ tầng ngoài API, gồm máy chủ chạy agent, môi trường thực thi, cơ sở dữ liệu vector, lưu trữ log và hệ thống giám sát. Đây không phải lúc nào cũng là phí của OpenAI, nhưng vẫn thuộc tổng chi phí sở hữu khi triển khai AI coding trong sản phẩm hoặc đội nhóm.
Vì vậy, cùng một model có thể tạo ra hai hóa đơn rất khác nhau. Quy trình chọn đúng tệp, giới hạn số lượt thử lại và kiểm soát đầu ra thường quan trọng không kém đơn giá token.
So sánh GPT‑6 Sol và Luna theo tiêu chí chi phí – hiệu quả
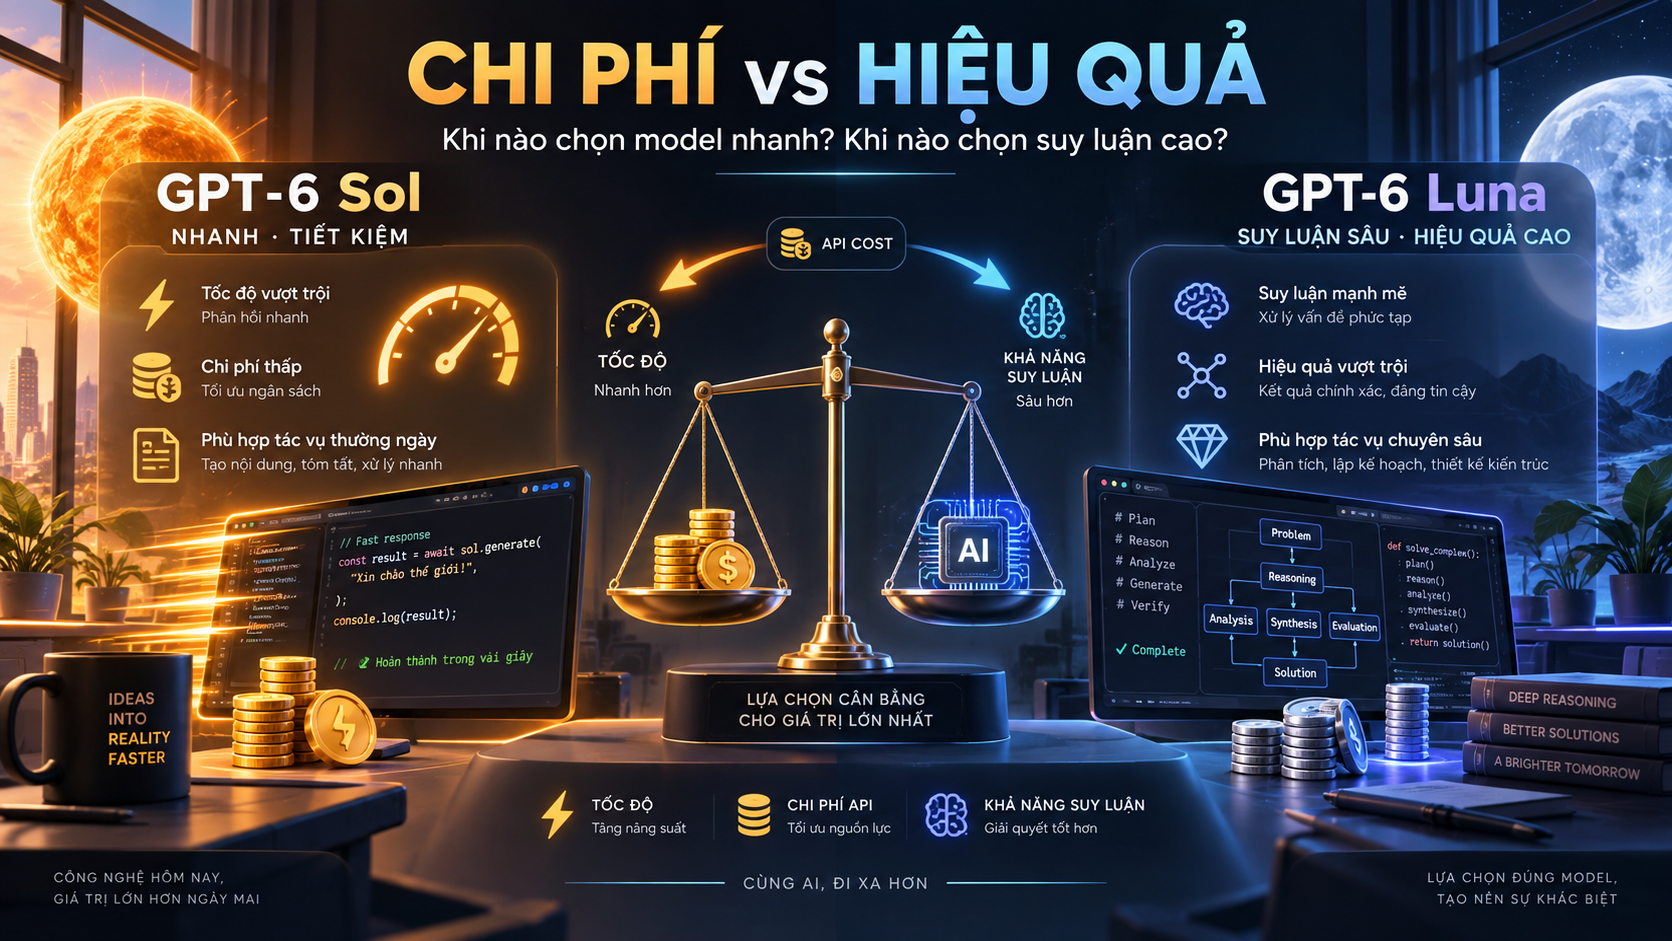
Việc so sánh GPT‑6 Sol và Luna trong Codex chỉ có ý nghĩa khi OpenAI công bố rõ định vị, biểu giá và khả năng của từng model. Trước thời điểm đó, không nên mặc định Sol mạnh hơn, Luna nhanh hơn hoặc một model sẽ rẻ hơn model còn lại.
| Tiêu chí | GPT‑6 Sol | GPT‑6 Luna | Cách đánh giá phù hợp |
|---|---|---|---|
| Trạng thái xác nhận | Chưa đủ cơ sở xác nhận từ thông tin được cung cấp | Chưa đủ cơ sở xác nhận từ thông tin được cung cấp | Kiểm tra tài liệu và thông báo chính thức của OpenAI |
| Giá đầu vào, đầu ra | Chưa được công bố trong phạm vi bài viết | Chưa được công bố trong phạm vi bài viết | Không thay thế bằng giá của model cũ |
| Tốc độ, ngữ cảnh | Chưa có dữ liệu xác minh | Chưa có dữ liệu xác minh | Thử trên tác vụ và kho mã đại diện |
| Khả năng dùng công cụ | Chưa có dữ liệu xác minh | Chưa có dữ liệu xác minh | Kiểm tra terminal, tìm kiếm, tệp và giới hạn agent |
| Trường hợp sử dụng | Chỉ xác định sau khi có định vị chính thức | Chỉ xác định sau khi có định vị chính thức | Đánh giá theo chi phí trên tác vụ hoàn thành |
Model có đơn giá thấp hơn chưa chắc tạo tổng chi phí thấp hơn. Nếu kết quả thiếu ổn định và cần ba lần sửa, hóa đơn cuối cùng có thể cao hơn một model đắt hơn nhưng hoàn thành đúng ngay từ lượt đầu.
Ngược lại, model mạnh nhất thường không cần thiết cho định dạng dữ liệu, viết hàm nhỏ hoặc tóm tắt log. Tiêu chí hợp lý là tỷ lệ hoàn thành, số lượt thử lại, độ trễ và thời gian kiểm tra của con người.
Khi nào nên ưu tiên model nhanh và tiết kiệm?
Model tiết kiệm phù hợp với hoàn thành mã đơn giản, tạo dữ liệu mẫu, viết kiểm thử cơ bản, phân loại tệp và chuyển đổi định dạng. Đây cũng là lựa chọn tốt khi kết quả có thể được kiểm tra tự động bằng linter, type checker hoặc bộ test.
Một quy trình hiệu quả có thể dùng model nhanh để tìm tệp liên quan và chuẩn bị dữ liệu, sau đó chuyển vấn đề khó sang model suy luận tốt hơn. Cách định tuyến này tránh dùng tài nguyên cao cấp cho mọi bước.
Khi nào model có năng lực suy luận cao đáng với chi phí?
Model mạnh hơn đáng cân nhắc cho tái cấu trúc hệ thống, phân tích lỗi liên tệp, thiết kế kiến trúc và nhiệm vụ có nhiều ràng buộc. Giá trị cần được đo bằng thời gian kỹ sư tiết kiệm được và mức giảm rủi ro, không chỉ bằng giá token.
Trước khi chuẩn hóa, đội nhóm nên chạy hai model trên cùng một tập nhiệm vụ thực tế. Kết quả cần ghi nhận số lượt thành công, thời gian hoàn thành, lượng token và công sức chỉnh sửa thủ công.
Dùng GPT‑6 Sol và Luna trong Codex mỗi ngày có thể tốn bao nhiêu?
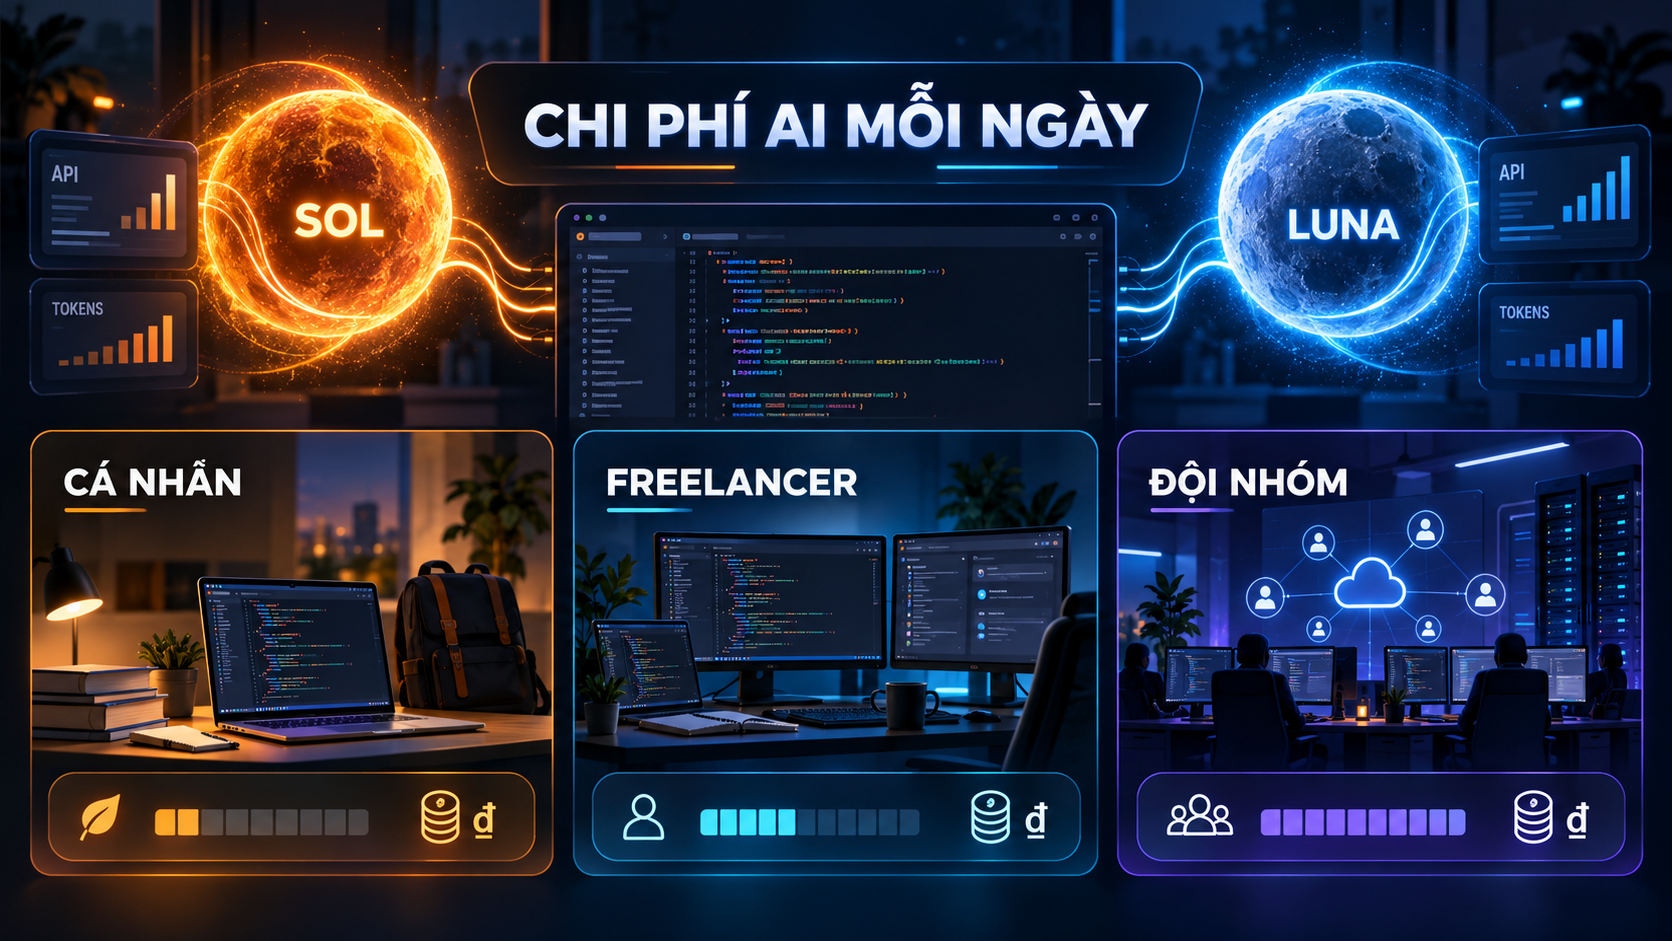
Khi chưa có biểu giá chính thức, không thể đưa ra một con số tiền tệ đáng tin cậy. Bạn vẫn có thể lập ngân sách bằng công thức: chi phí trung bình mỗi tác vụ nhân số tác vụ mỗi ngày, sau đó cộng retry, công cụ và hạ tầng.
| Dữ liệu trong bảng tính | Cách ghi nhận |
|---|---|
| Số phiên mỗi ngày | Đếm phiên làm việc thực tế, không chỉ số prompt |
| Token trung bình | Tách đầu vào, đầu ra và cache theo model |
| Lượt thử lại | Gồm retry tự động và yêu cầu sửa thủ công |
| Chi phí công cụ | Terminal, tìm kiếm, lưu trữ hoặc dịch vụ ngoài |
| Số ngày sử dụng | Dùng ngày làm việc thực tế trong chu kỳ |
Kho mã lớn, tài liệu kém và bộ kiểm thử phức tạp thường khiến agent cần nhiều vòng hơn. Ngôn ngữ lập trình, chất lượng thông báo lỗi và quyền tự chủ của agent cũng làm mức dùng biến động đáng kể.
Kịch bản 1: Người dùng cá nhân và sinh viên
Nhu cầu thường gồm giải thích mã, học cú pháp, viết hàm nhỏ và sửa lỗi trong một vài tệp. Người dùng có thể đặt hạn mức ngày, dùng model tiết kiệm cho câu hỏi thường lệ và chỉ chuyển model khi gặp lỗi khó.
Nếu chủ yếu trò chuyện và sao chép mã thủ công, gói giao diện cố định có thể dễ dự đoán hơn API. API phù hợp hơn khi cần tích hợp IDE, tự động hóa hoặc chạy CLI.
Kịch bản 2: Freelancer và lập trình viên chuyên nghiệp
Khối lượng tăng khi AI phải tạo mã, viết test, đọc tài liệu và hỗ trợ nhiều dự án. Hãy tính cả phản hồi khách hàng, số vòng chỉnh sửa và thời gian kiểm tra trước khi đánh giá hiệu quả kinh tế.
Một cách thực tế là dùng model nhanh cho tài liệu, boilerplate và kiểm tra ban đầu; model suy luận dành cho lỗi liên tệp hoặc quyết định kiến trúc. Ngân sách nên được đo theo từng dự án để tránh khách hàng này sử dụng tín dụng của khách hàng khác.
Kịch bản 3: Đội nhóm dùng Coding Agent hoặc AI Agent
Đội nhóm cần nhân mức dùng theo thành viên, kho mã, tác vụ nền và số lượt chạy tự động. Một yêu cầu đơn giản ở giao diện có thể kích hoạt nhiều lần đọc tệp, gọi model và chạy kiểm thử phía sau.
Nên đặt hạn mức theo dự án và người dùng, đồng thời tập trung nhật ký chi phí vào một nơi. Cảnh báo sớm giúp phát hiện vòng lặp agent, khóa bị lạm dụng hoặc tác vụ nền chạy ngoài kế hoạch.
Các yếu tố làm chi phí thực tế tăng cao và cách tối ưu
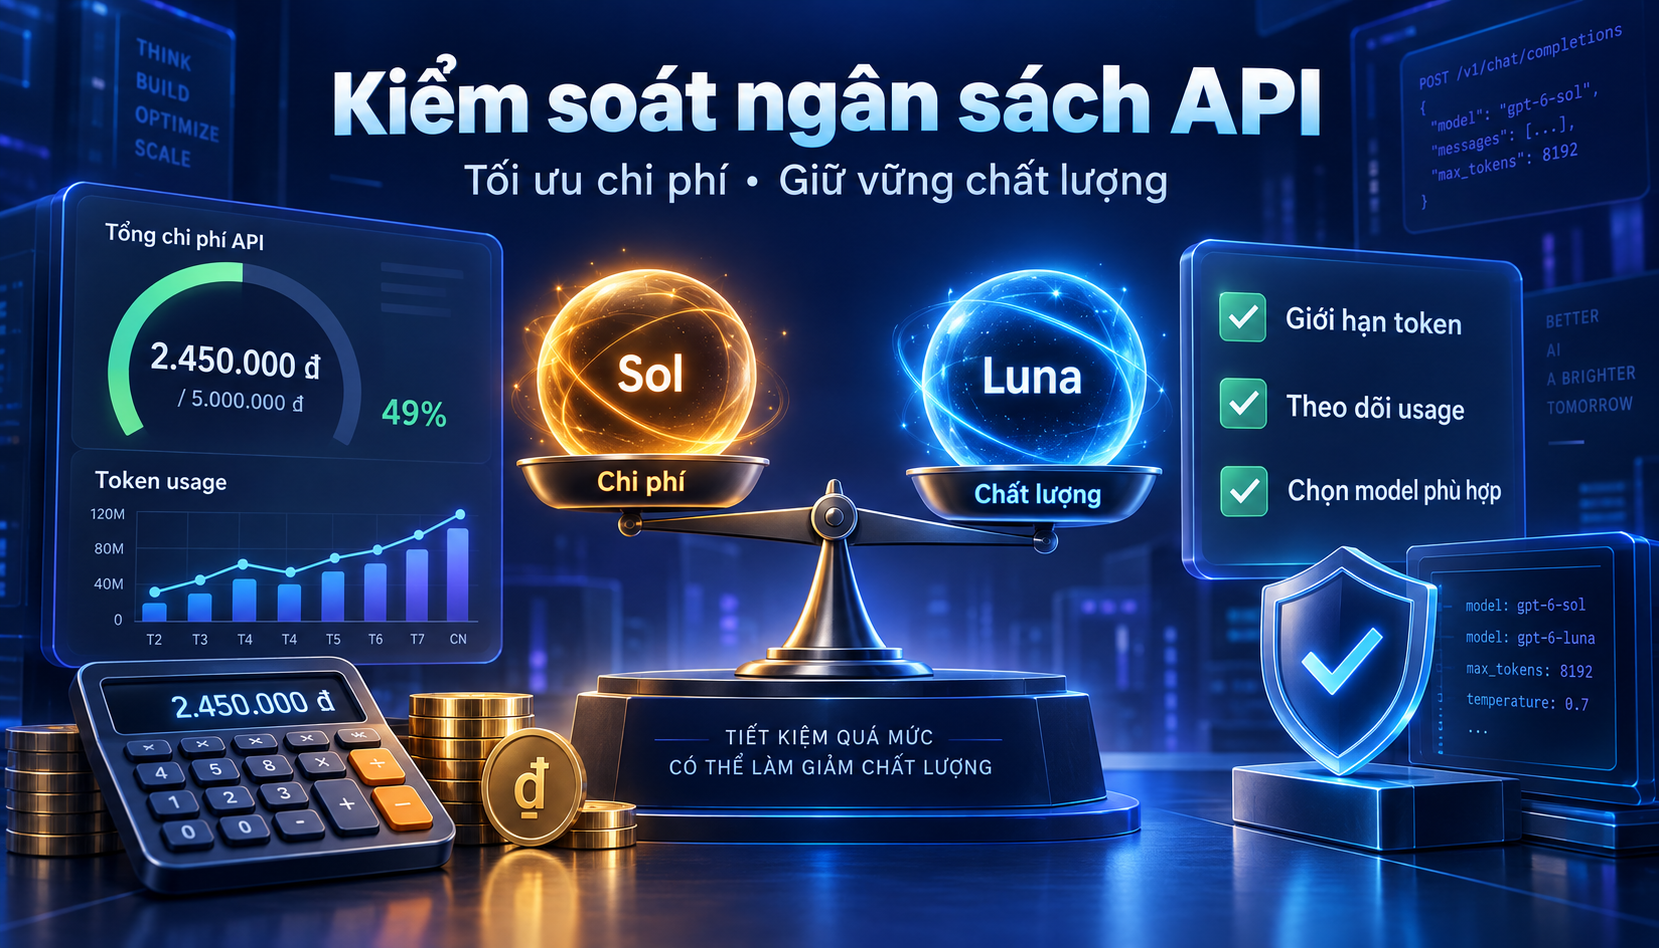
Prompt dài không phải nguyên nhân duy nhất gây tốn phí. Việc gửi lại toàn bộ kho mã, cho phép retry không giới hạn và dùng model mạnh cho mọi tác vụ thường tác động lớn hơn.
Trước tối ưu, agent có thể đọc cả thư mục, in lại tệp hoàn chỉnh rồi chạy test nhiều lần. Sau tối ưu, hệ thống chỉ chọn tệp liên quan, yêu cầu bản vá ngắn, giới hạn vòng lặp và chuyển model khi độ khó tăng.
Checklist kiểm soát ngân sách API
- Đặt hạn mức theo ngày, tháng, dự án và thành viên.
- Theo dõi token đầu vào, đầu ra, cache, lỗi và tỷ lệ retry.
- Cảnh báo khi mức dùng vượt ngưỡng và dừng tác vụ tự động bất thường.
- Tóm tắt hội thoại dài, xóa ngữ cảnh thừa và giới hạn số tệp được đọc.
- Định tuyến việc thường lệ sang model tiết kiệm, việc khó sang model mạnh.
- Đo chi phí trên mỗi tác vụ hoàn thành thay vì chỉ nhìn giá mỗi triệu token.
- Không gửi khóa API, dữ liệu khách hàng hoặc mã nhạy cảm khi chưa có chính sách bảo mật phù hợp.
Những cách tiết kiệm có thể làm giảm chất lượng
Cắt ngữ cảnh quá mạnh có thể khiến model bỏ sót phụ thuộc giữa các tệp. Giới hạn đầu ra quá ngắn cũng có thể làm bản vá thiếu mã, thiếu cảnh báo hoặc không giải thích thay đổi quan trọng.
Model rẻ nhất không phải lúc nào cũng tối ưu nếu tạo nhiều lỗi và tăng thời gian kiểm tra. Cần cân bằng đơn giá, độ chính xác, tốc độ, tỷ lệ thành công và công sức của kỹ sư.
Câu hỏi thường gặp và kết luận lựa chọn ngân sách
GPT‑6 Sol và GPT‑6 Luna đã được OpenAI xác nhận chưa?
Chưa đủ cơ sở để xác nhận từ thông tin có thể kiểm chứng trong phạm vi bài viết. Tên model xuất hiện trên mạng hoặc nền tảng bên thứ ba không thay thế cho tài liệu sản phẩm, bảng giá hay thông báo chính thức của OpenAI.
Dùng Codex có bị tính thêm ngoài phí token không?
Điều này phụ thuộc vào sản phẩm, công cụ được gọi và hạ tầng liên quan. Hãy kiểm tra bảng giá hiện hành, điều khoản nền tảng và nhật ký sử dụng để xác định có phí terminal, thực thi, lưu trữ hoặc dịch vụ ngoài hay không.
Chi phí API mỗi ngày nên được ước tính ra sao?
Lấy chi phí trung bình mỗi tác vụ nhân số tác vụ hằng ngày, rồi cộng retry, công cụ và hạ tầng. Tốt nhất nên đo trong một tuần làm việc đại diện trước khi dự báo chu kỳ 30 ngày.
Có nên dùng một model cho toàn bộ công việc coding?
Thường không cần thiết khi nhiệm vụ có độ khó khác nhau. Model tiết kiệm có thể xử lý việc thường lệ, còn model mạnh hơn được dành cho suy luận nhiều bước, kiểm tra cuối hoặc lỗi phức tạp.
CentriX có phải đơn vị phát triển GPT‑6 Sol và Luna không?
Để tìm hiểu thêm về chủ đề này, bạn có thể tham khảo thêm các bài viết khác trên website.